 DuckLocal
DuckDB 2.0(代号 Cyanoptera)计划于 2026 年 10 月 21 日发布。距 3 月的 1.5 版本仅七个月,代码提交已超过 10,000 次。
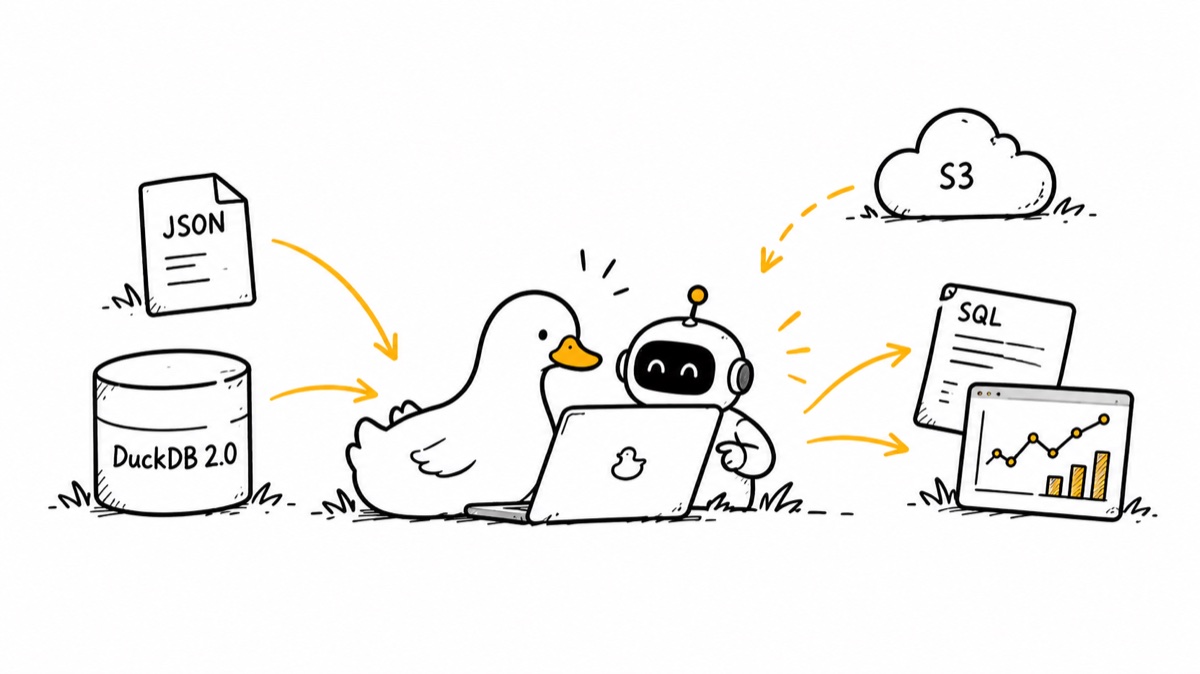
新版本带来了新的存储格式、SQL Parser、异步 I/O 和更完善的 VARIANT 支持,还新增了 Server 模式和面向 AI 智能体的 CLI Agent Mode。在我看来,比起某条查询快了多少,更值得关注的是:DuckDB 正在重新定义数据分析工具的形态。
我长期在 SRE、Observability 和安全分析领域工作,最近在开发基于 DuckDB 的开源本地优先分析工具 DuckLocal。一个越来越明显的感受是:未来的数据分析,可能不再是人打开 BI 工具写 SQL、配仪表盘,而是人与 AI 智能体协作完成。DuckDB 2.0 的几项变化,恰好契合这个方向。
一、Agent Mode:数据库开始把智能体当作用户
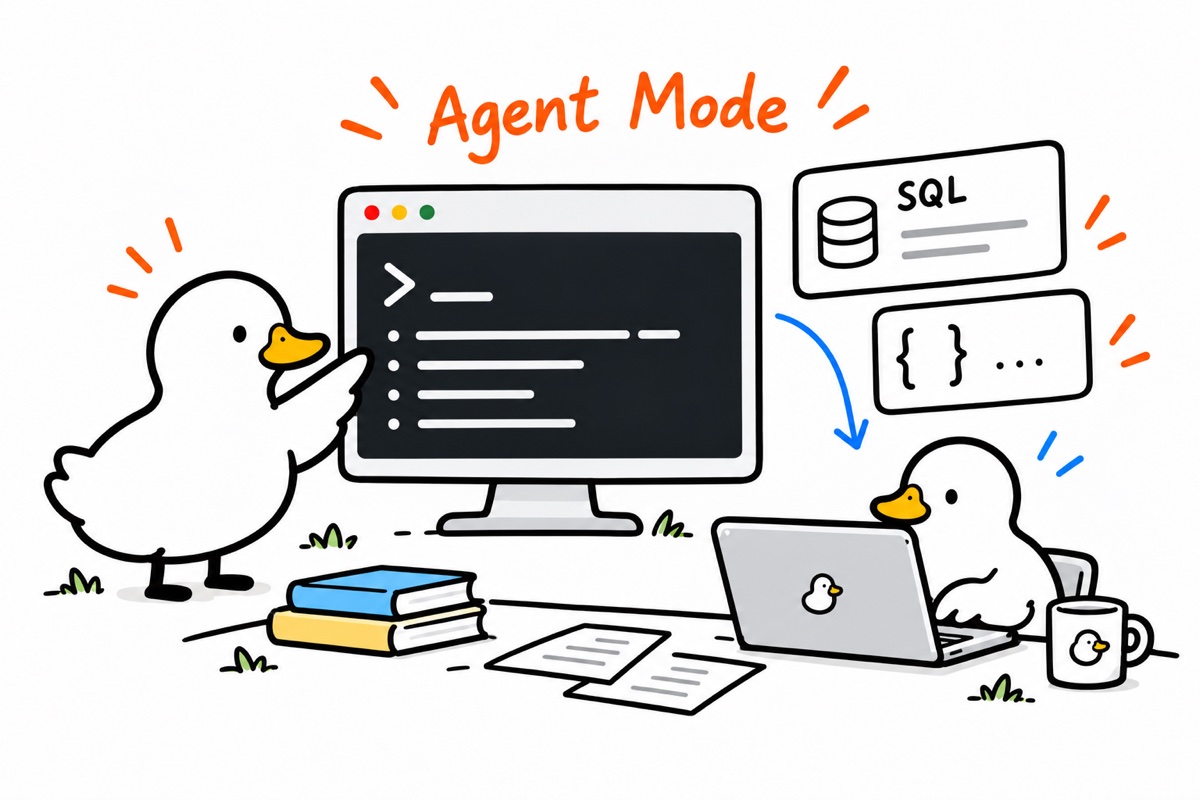
传统 CLI 为人设计,比如 DuckDB CLI 的带边框和对齐空格的表格对智能体并不友好。这会带来一些问题:对齐字符浪费 Token;结果被截断时,智能体可能误以为已读完全部数据;错误信息不够结构化;长查询可能空耗时间。
Agent Mode 在检测到 Claude Code、Codex 等环境时会自动切换输出,改用紧凑的 Markdown 表格、明确的截断提示、JSON 格式错误,并为长查询提供执行反馈。
官方实验用 Claude Code 以自然语言完成 TPC-H 的 22 道查询,两种模式各跑三次,共 132 次,全部答对。模型读取的 DuckDB 输出从 123.6K Token 降至 50.8K,减少约 59%。需要注意的是,这是输出侧的节省,不等于任务总消耗降低 59%。官方报告中,这部分节省约占总输入的 0.5%,并未体现为总成本或运行时间的下降。实验与说明
我们讨论智能体用数据库时,往往只关注 Text-to-SQL 的准确率。但数据库能否被智能体高效、可靠地调用,同样重要。
二、VARIANT:半结构化数据不必牺牲太多性能
CloudTrail、应用日志、OpenTelemetry 数据大多是结构不一的 JSON。以 CloudTrail 为例,不同事件的 requestParameters 可能完全不同。
传统做法有两种:存成字符串、查询时反复解析,灵活但慢;或者预定义表结构拆成列,快但表结构演进麻烦。VARIANT 试图兼顾两者,它保留灵活结构,底层通过 Shredding 把适合列式化的字段拆成独立子列。VARIANT 在 1.5 已引入,2.0 进一步完善了从存储到查询执行的支持。
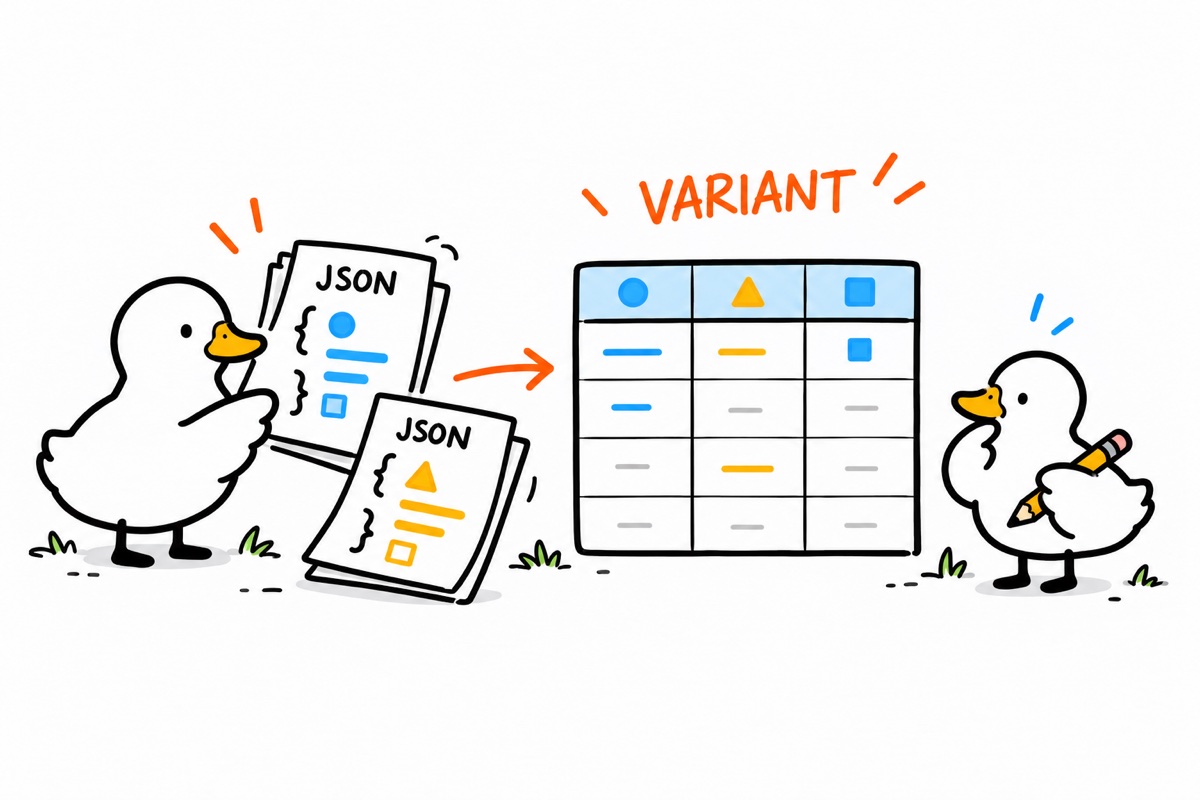
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ 写入时识别并拆分
eventName(字符串) | user(字符串) | success(布尔) ...
(概念示意,实际结构取决于数据分布和编码。)
社区测试中有场景获得约 6 倍查询提升,存储也显著减少,但这类数字依赖具体负载。
对安全分析来说,这意味着原始 CloudTrail 事件无需复杂 ETL,就能直接用于用户行为分析、异常 API 调用检测和权限变更排查。不一定要先搭建庞大的数据平台,一个 DuckDB 加上 SQL 和 AI 智能体,就能完成相当一部分调查工作。
三、异步 I/O:本地优先,不等于只分析本地数据
数据往往分布在 S3、对象存储或数据湖中。同步 I/O 在远程查询时容易受网络延迟拖累。2.0 的异步 I/O 允许后台同时发起多个读取请求,计算线程则处理已到达的数据。
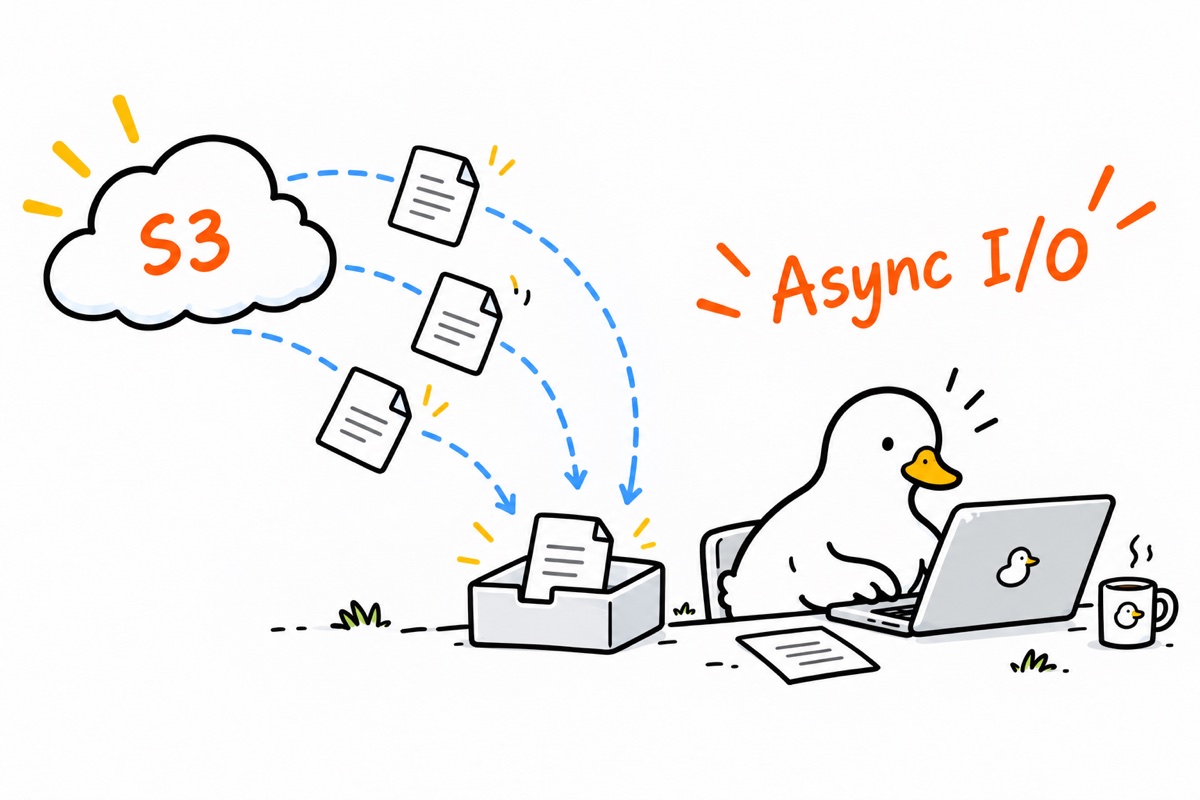
截至本文撰写时,I/O 文档列出的支持格式是 Parquet,以及未压缩、可寻址的 UTF-8 CSV;JSON 和 DuckDB 原生文件仍列为同步 I/O。2.0 预览文章也提到了原生格式的后续支持进展,实际支持范围应以所用版本为准。I/O 文档
四、DuckDB as a Server:突破单进程边界
DuckDB 生来是 In-process 数据库,直接嵌入 Python、Rust、C++ 应用,但这让多应用共享或远程执行变得不便。2.0 引入 Quack 协议和 CONNECT 语句,DuckDB 可以作为 Server 运行,客户端把 SQL 发往远端执行。它还支持把查询下推到 PostgreSQL、MySQL 等远程数据库,而不必把数据拉到本地。
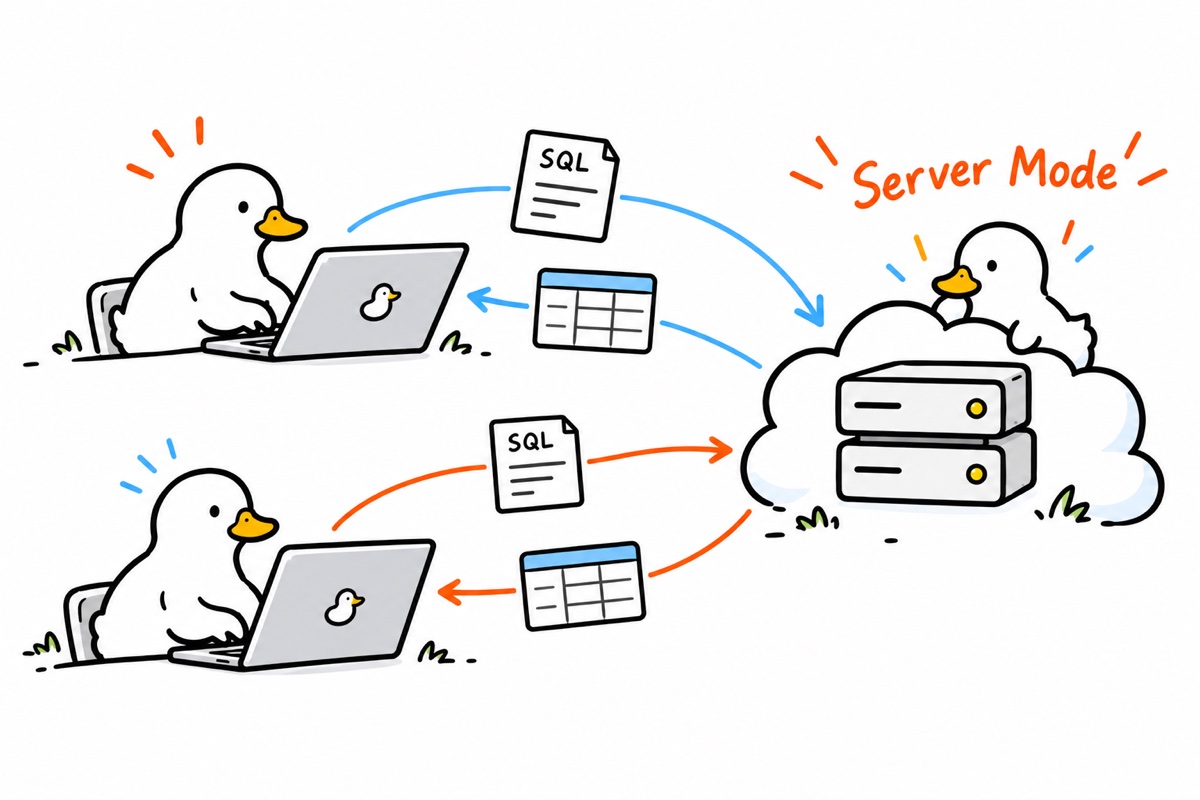
对企业场景而言,这一点很关键:团队协作的时候需要有统一的工作空间。理想的架构不是让数据流向 AI,而是让 AI 靠近数据。
需要说明的是,Quack 本身不是完整的企业级权限、审计和多租户方案,这些仍需应用层设计。但它提供了构建这种架构的基础。
本地优先是让用户拥有对数据和计算的控制权,而不是强制一切都发生在本地。
五、其他值得关注的改进
- 递归 CTE 重写:在 100 万条边的图可达性测试中,查询从 4.90 秒降到 0.12 秒,约快 40 倍。部分图遍历任务可以更高效地用 SQL 完成,但这不等于能替代专业图数据库。
- 自研 ICU 实现:去掉了对 ICU 库的依赖。微基准中时区转换快约 2.2 倍,德语排序规则过滤快约 2.6 倍,对嵌入式场景也意味着更小的体积。
- 稳定的扩展 API:重新设计 C API,引入版本化 ABI,并支持自托管扩展仓库,有望显著降低扩展随版本升级的维护成本,对 Rust 扩展开发者尤其友好。
- Triggers 与 PEG Parser:Trigger 可用于审计和数据变更处理;可扩展的 Parser 让扩展能深入参与语法解析,未来或许能为安全分析、Observability 设计领域专用语法。
六、升级注意事项
2.0 并非完全向后兼容。
- 存储格式:默认使用新格式创建或写入的数据库文件无法被旧版本打开;需要兼容旧版时,应显式指定存储兼容版本。已有数据库可以按官方迁移指南导出、导入。
- Lambda 语法:旧语法默认禁用,可临时开启兼容,计划在 2.1 移除。
-- 旧
SELECT list_transform([1, 2, 3], x -> x + 1);
-- 新
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- C++ 扩展:需要确认是否已完成适配。
生产环境建议先验证现有查询、数据库文件和第三方扩展。桌面应用尤其不应在用户不知情时自动迁移格式,否则旧版本将无法重新打开数据。迁移指南
七、结语
为了分析一个 CSV 或几 GB 日志,我们常常要先部署数据库、配置管道、维护服务。这对大型企业的数据平台或许合理,但对个人开发者、安全分析师和大量临时分析任务未必必要。
DuckDB 把分析引擎直接嵌入应用,2.0 又补上了 Server 模式、Agent Mode 和更成熟的扩展生态。数据库、AI 智能体和可视化界面,不必再是三个独立的系统,它们可以组成一个轻量、可嵌入的数据分析工作空间。
这正是我开发 DuckLocal 的原因。它是一款开源的本地优先数据分析桌面应用,支持 SQL、可视化仪表盘以及人与 AI 协作分析。AI 帮助探索数据,但数据由用户控制,执行过程可检查,SQL 保持透明。
参考资料
截至 2026 年 10 月 19 日,2.0 尚未正式发布;发布日期与功能细节以官方最终发布为准。