 DuckLocal
O DuckDB 2.0, com codinome Cyanoptera, está previsto para 21 de outubro de 2026. Apenas sete meses depois do lançamento da 1.5 em março, o projeto acumulou mais de 10.000 commits.
A nova versão traz um novo formato de armazenamento, um novo parser SQL, E/S assíncrona e suporte mais completo a VARIANT, além do modo servidor e de um Agent Mode na CLI projetado para agentes de IA. Para mim, a história interessante vai além de quanto mais rápida uma consulta individual roda: o DuckDB está mudando o que uma ferramenta de análise de dados pode ser.
Passei boa parte da minha carreira trabalhando com SRE, observabilidade e análise de segurança. Mais recentemente, venho construindo o DuckLocal, uma ferramenta de análise local-first de código aberto movida a DuckDB. Vejo cada vez mais um futuro em que a análise é uma colaboração entre pessoas e agentes de IA, em vez de uma pessoa abrindo uma ferramenta de BI para escrever SQL e configurar dashboards. Várias mudanças no DuckDB 2.0 apontam nessa direção.
1. Agent Mode: tratar agentes como usuários do banco de dados
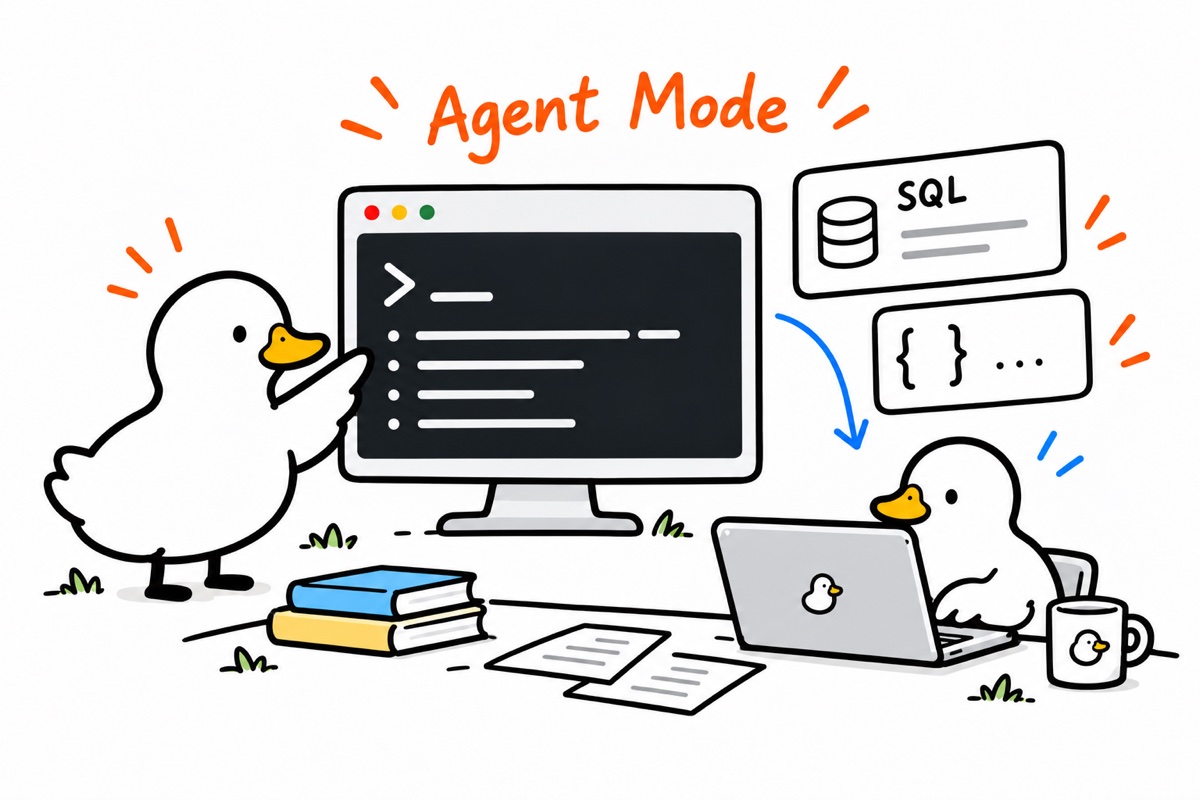
Interfaces de linha de comando tradicionais são projetadas para pessoas. As bordas e os espaços de alinhamento em uma tabela da CLI do DuckDB são menos úteis para um agente. O preenchimento consome tokens; um resultado truncado pode parecer completo; erros podem não ter estrutura; e uma consulta longa pode deixar o agente esperando sem feedback útil.
Agent Mode detecta ambientes como Claude Code e Codex e ajusta a saída automaticamente. Ele usa tabelas Markdown compactas, avisos explícitos de truncamento e erros em JSON, e fornece feedback para consultas de longa duração.
Em um experimento oficial, o Claude Code respondeu a todas as 22 perguntas do TPC-H a partir de prompts em linguagem natural. Cada pergunta rodou três vezes em cada modo, totalizando 132 execuções, e todas produziram a resposta correta. A saída do DuckDB lida pelo modelo caiu de 123,6K para 50,8K tokens, uma redução de cerca de 59%. Isso mede a economia na saída da consulta, não uma redução de 59% no custo total da tarefa. O relatório estima a economia em cerca de 0,5% da entrada total e não encontrou redução no custo ou no tempo de execução geral. Experimento e explicação
Discussões sobre agentes usando bancos de dados costumam focar na precisão de text-to-SQL. A eficiência e a confiabilidade com que um agente interage com o banco importam na mesma medida.
2. VARIANT: dados flexíveis com menos concessões de desempenho
Eventos do CloudTrail, logs de aplicação e dados do OpenTelemetry frequentemente chegam como JSON com estruturas variadas. No CloudTrail, por exemplo, o formato de requestParameters pode ser completamente diferente de um evento para outro.
Existem duas abordagens conhecidas: armazenar os registros como strings e analisá-los repetidamente no momento da consulta, o que é flexível mas lento; ou definir um esquema e dividir os dados em colunas, o que é rápido mas torna a evolução do esquema mais trabalhosa. O VARIANT busca combinar essas vantagens. Ele preserva a estrutura flexível enquanto usa shredding para separar campos adequados em subcolunas individuais. O VARIANT chegou na 1.5; a versão 2.0 estende seu suporte do armazenamento até a execução de consultas.
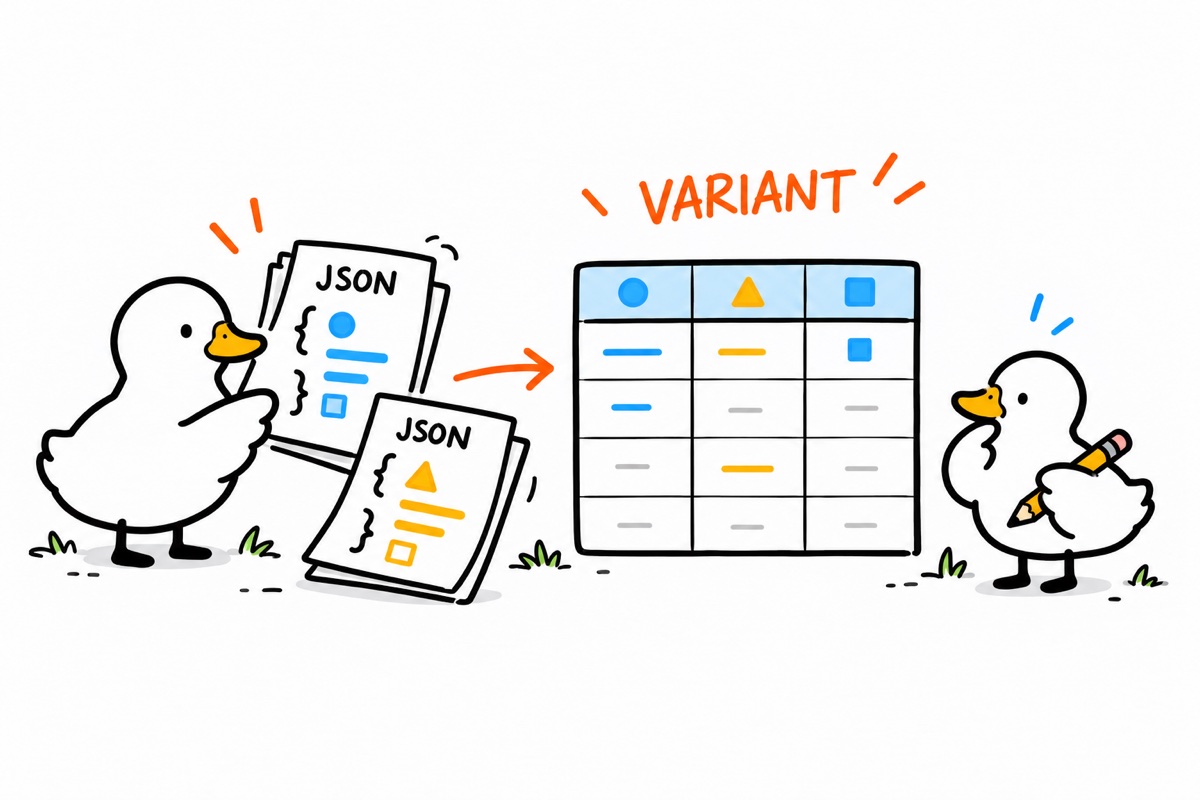
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ Identifique e separe campos durante as gravações
eventName(string) | user(string) | success(boolean) ...
O layout real depende da distribuição dos dados e da codificação.
Alguns testes da comunidade relataram ganhos de velocidade de consulta de cerca de 6×, junto com armazenamento substancialmente menor. Esses números dependem da carga de trabalho.
Para a análise de segurança, isso abre um caminho dos eventos brutos do CloudTrail até a análise da atividade de usuários, a detecção de chamadas de API incomuns e a investigação de mudanças de permissão sem um pipeline de ETL complexo. Uma grande plataforma de dados nem sempre é o ponto de partida: DuckDB, SQL e um agente de IA podem sustentar uma parte substancial de uma investigação.
3. E/S assíncrona: local-first pode incluir dados remotos
Os dados muitas vezes vivem no S3, em outros armazenamentos de objetos ou em um data lake. Com E/S síncrona, a latência de rede pode travar consultas remotas. A E/S assíncrona do DuckDB 2.0 permite que várias leituras rodem em segundo plano enquanto as threads de processamento de consultas trabalham sobre dados que já chegaram.
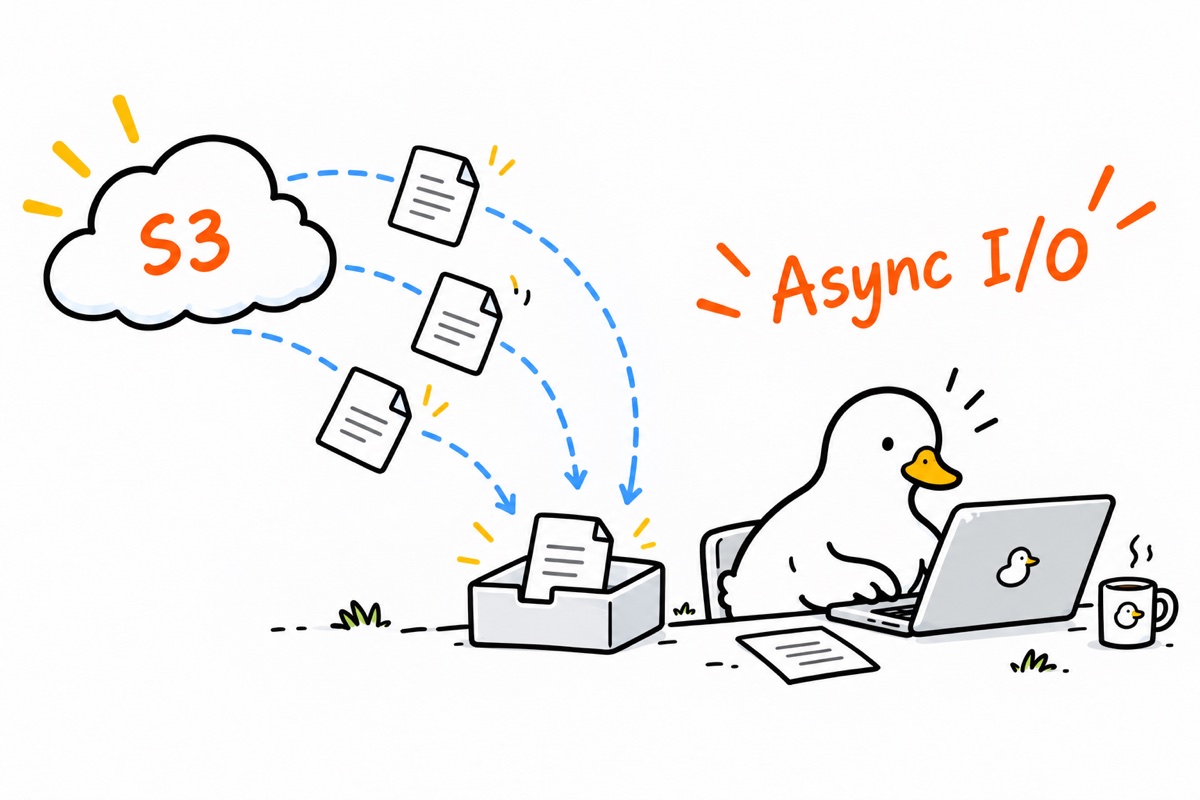
No momento em que escrevo, a documentação de E/S lista suporte para Parquet e para arquivos CSV UTF-8 não comprimidos e com busca (seekable); JSON e arquivos nativos do DuckDB ainda aparecem como usando E/S síncrona. O artigo de preview da 2.0 também menciona progresso rumo ao suporte ao formato nativo, então verifique as capacidades da versão que você usa. Documentação de E/S
4. DuckDB como servidor: além de um único processo
O DuckDB começou como um banco de dados in-process, embutido diretamente em aplicações Python, Rust e C++. Esse modelo torna menos conveniente compartilhar um banco entre aplicações ou executar consultas remotamente. A versão 2.0 introduz o protocolo Quack e o comando CONNECT, permitindo que o DuckDB rode como servidor e que clientes enviem SQL para execução remota. Ele também suporta o pushdown de consultas para bancos remotos como PostgreSQL e MySQL, em vez de trazer os dados para o processo local.
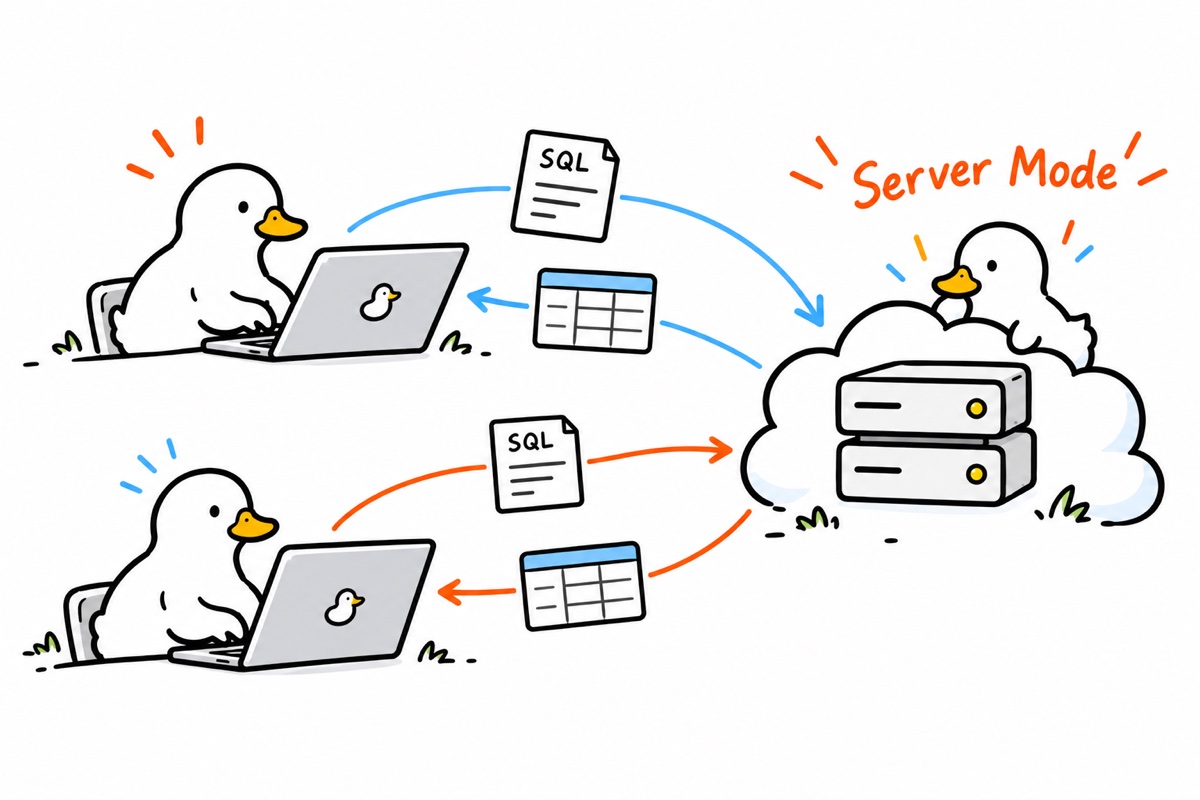
Isso importa para o uso corporativo: equipes precisam de um workspace compartilhado. A arquitetura que eu quero aproxima a IA dos dados, com a computação rodando onde os dados pertencem.
O Quack não é, por si só, uma solução corporativa completa para permissões, auditoria e multi-tenancy. Isso ainda exige design na camada de aplicação. O que ele oferece é uma base para construir essa arquitetura.
Local-first significa dar aos usuários controle sobre seus dados e sua computação. Não exige que tudo aconteça localmente.
5. Outras melhorias que vale acompanhar
- Um motor de CTE recursivo reescrito. Em um teste de alcançabilidade em grafo com um milhão de arestas, o tempo de consulta caiu de 4,90 segundos para 0,12 segundos, cerca de 40× mais rápido. Algumas tarefas de travessia de grafo se tornam mais práticas em SQL, embora isso não transforme o DuckDB em substituto de um banco de dados de grafos especializado.
- Substituições nativas para funcionalidades do ICU. O DuckDB remove sua dependência da biblioteca ICU. Em microbenchmarks, a conversão de fuso horário ficou cerca de 2,2× mais rápida e a filtragem com collation alemã cerca de 2,6× mais rápida. Um consumo de recursos menor também beneficia aplicações embutidas.
- Uma API de extensões estável. Uma API C redesenhada, ABI versionada e suporte a repositórios de extensões auto-hospedados podem reduzir substancialmente a manutenção necessária entre atualizações do DuckDB. Isso é especialmente promissor para desenvolvedores de extensões em Rust.
- Triggers e um parser PEG. Triggers podem apoiar auditoria e processamento de mudanças em dados. Um parser extensível dá às extensões acesso mais profundo à análise de SQL, potencialmente abrindo a porta para sintaxe específica de domínio para análise de segurança e observabilidade.
6. Antes de atualizar
A versão 2.0 não é totalmente compatível com versões anteriores.
- Formato de armazenamento. Arquivos criados ou gravados com o novo formato padrão não podem ser abertos por versões mais antigas. Se leitores antigos precisarem continuar funcionando, defina uma versão explícita de compatibilidade de armazenamento. Bancos existentes podem ser exportados e importados seguindo as orientações oficiais de migração.
- Sintaxe de lambda. A sintaxe antiga fica desabilitada por padrão. Uma configuração temporária de compatibilidade pode habilitá-la, mas a remoção está prevista para a 2.1.
-- Old
SELECT list_transform([1, 2, 3], x -> x + 1);
-- New
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- Extensões C++. Verifique se há builds compatíveis disponíveis antes de atualizar.
Valide consultas existentes, arquivos de banco de dados e extensões de terceiros antes de mover cargas de trabalho de produção. Aplicações de desktop devem ter cuidado especial para não migrar o formato de arquivo de um usuário silenciosamente: uma versão mais antiga do aplicativo pode não conseguir mais abri-lo. Guia de migração
7. Considerações finais
Analisar um CSV ou alguns gigabytes de logs muitas vezes começa com a implantação de um banco de dados, a configuração de pipelines e a manutenção de serviços. Isso pode fazer sentido para uma grande plataforma de dados corporativa, mas nem sempre é necessário para desenvolvedores individuais, analistas de segurança ou investigações pontuais.
O DuckDB embute um motor analítico diretamente em uma aplicação. A versão 2.0 adiciona o modo servidor, o Agent Mode e um ecossistema de extensões mais maduro. O banco de dados, o agente de IA e a interface visual podem se reunir em um workspace de análise de dados leve e embutível.
É por isso que estou construindo o DuckLocal, um aplicativo de desktop local-first e de código aberto para SQL, dashboards visuais e análise colaborativa com IA. A IA ajuda a explorar os dados enquanto o usuário mantém o controle, a execução permanece inspecionável e o SQL continua transparente.
Referências
Em 19 de outubro de 2026, o DuckDB 2.0 ainda não havia sido lançado. A data de lançamento e os detalhes dos recursos permanecem sujeitos ao anúncio oficial final.