 DuckLocal
DuckDB 2.0, nome in codice Cyanoptera, è previsto per il 21 ottobre 2026. A soli sette mesi dal rilascio della 1.5 a marzo, il progetto ha accumulato più di 10.000 commit.
La nuova versione introduce un nuovo formato di archiviazione, un nuovo parser SQL, I/O asincrono e un supporto più completo a VARIANT, insieme alla modalità server e a un Agent Mode per la CLI pensato per gli agenti AI. Per me la storia interessante va oltre quanto è diventata più veloce una singola query: DuckDB sta cambiando l'aspetto che può avere uno strumento di analisi dei dati.
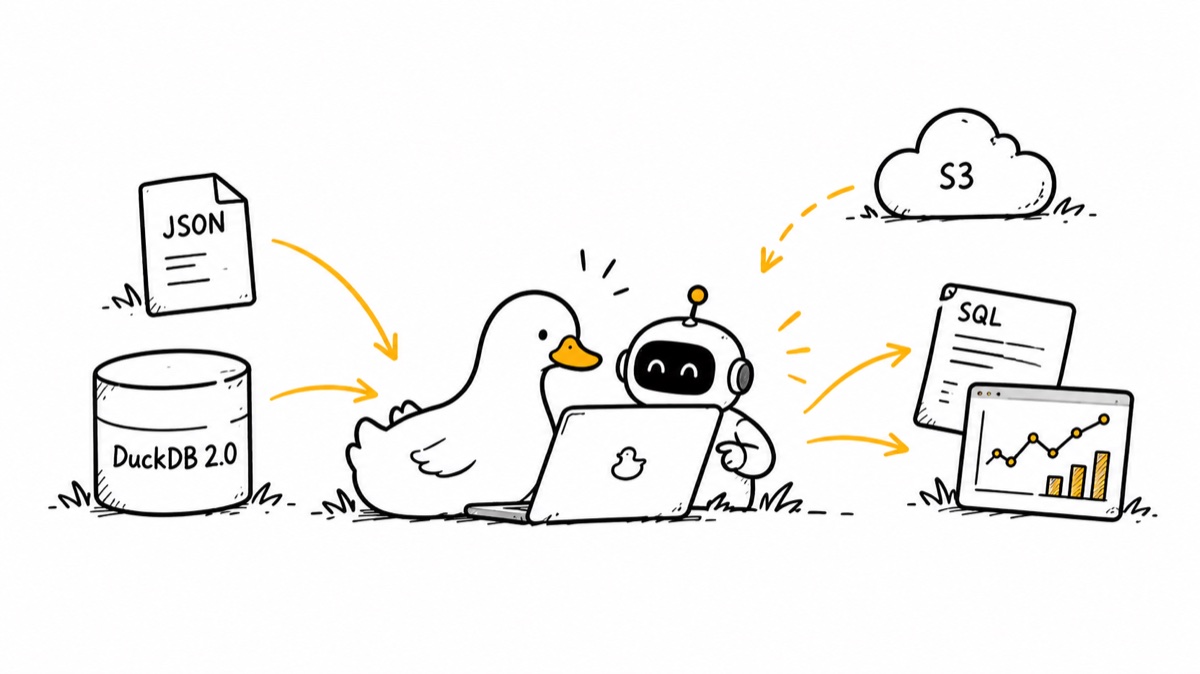
Ho passato gran parte della mia carriera lavorando su SRE, observability e analisi di sicurezza. Più di recente ho costruito DuckLocal, uno strumento di analisi open source e local-first basato su DuckDB. Vedo sempre più spesso un futuro in cui l'analisi è una collaborazione tra persone e agenti AI, invece di una persona che apre uno strumento BI per scrivere SQL e configurare dashboard. Diversi cambiamenti di DuckDB 2.0 vanno in quella direzione.
1. Agent Mode: trattare gli agenti come utenti del database
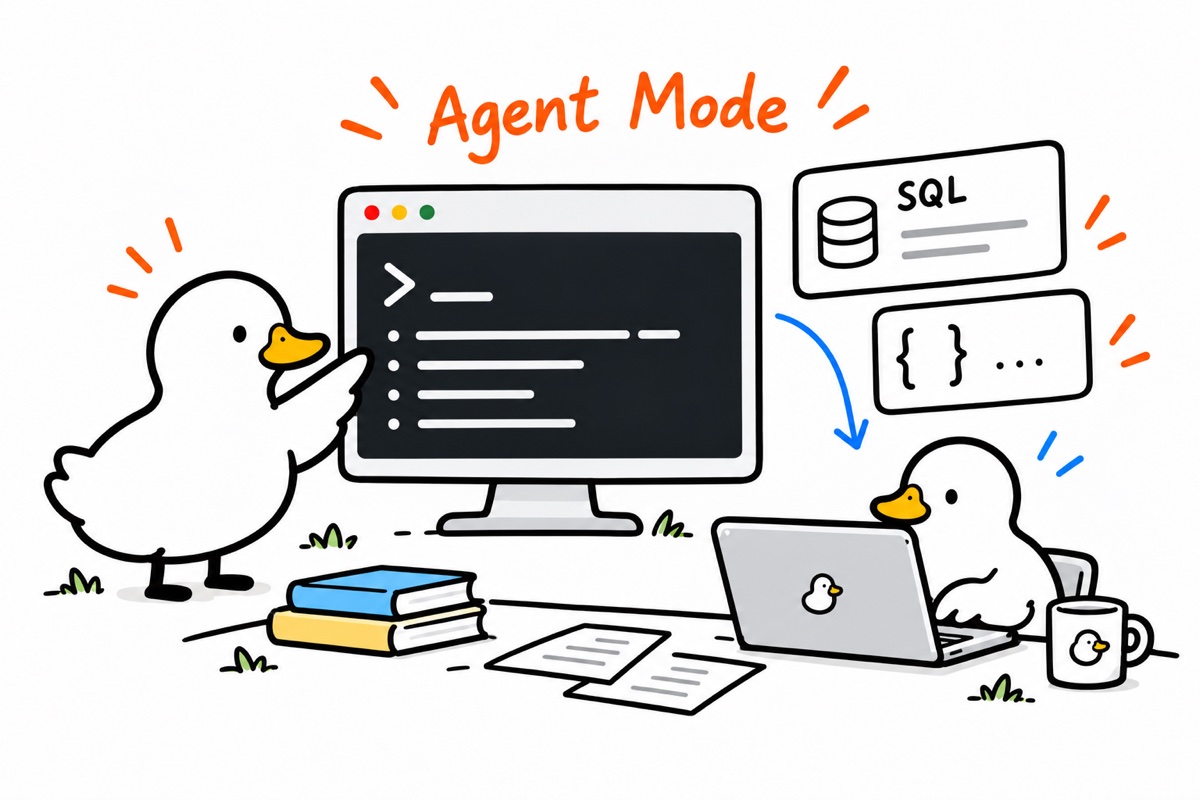
Le interfacce a riga di comando tradizionali sono progettate per le persone. I bordi e gli spazi di allineamento in una tabella della CLI di DuckDB sono poco utili a un agente. Il padding consuma token; un risultato troncato può sembrare completo; gli errori possono mancare di struttura; e una query lunga può lasciare l'agente in attesa senza feedback utili.
Agent Mode rileva ambienti come Claude Code e Codex e adatta automaticamente l'output. Usa tabelle Markdown compatte, avvisi espliciti di troncamento ed errori in JSON, e fornisce feedback per le query di lunga durata.
In un esperimento ufficiale, Claude Code ha risposto a tutte le 22 domande TPC-H a partire da prompt in linguaggio naturale. Ogni domanda è stata eseguita tre volte per ciascuna modalità, per 132 esecuzioni in totale, e ogni esecuzione ha prodotto la risposta corretta. L'output di DuckDB letto dal modello è sceso da 123,6K a 50,8K token, una riduzione di circa il 59%. Questo misura il risparmio sull'output delle query, non una riduzione del 59% del costo totale dell'attività. Il report stima il risparmio intorno allo 0,5% dell'input totale e non ha rilevato riduzioni del costo complessivo o del tempo di esecuzione. Esperimento e spiegazione
Le discussioni sugli agenti che usano i database spesso si concentrano sull'accuratezza del text-to-SQL. Quanto efficientemente e affidabilmente un agente riesce a interagire con il database conta altrettanto.
2. VARIANT: dati flessibili con meno compromessi sulle prestazioni
Gli eventi CloudTrail, i log applicativi e i dati OpenTelemetry arrivano spesso come JSON con strutture variabili. In CloudTrail, per esempio, la forma di requestParameters può essere completamente diversa da un evento all'altro.
Ci sono due approcci noti: memorizzare i record come stringhe e analizzarli ripetutamente al momento della query, il che è flessibile ma lento; oppure definire uno schema e dividere i dati in colonne, il che è veloce ma rende l'evoluzione dello schema più onerosa. VARIANT mira a combinare questi vantaggi. Preserva la struttura flessibile usando lo shredding per separare i campi adatti in sottocolonne individuali. VARIANT è arrivato nella 1.5; la versione 2.0 ne estende il supporto dall'archiviazione all'esecuzione delle query.
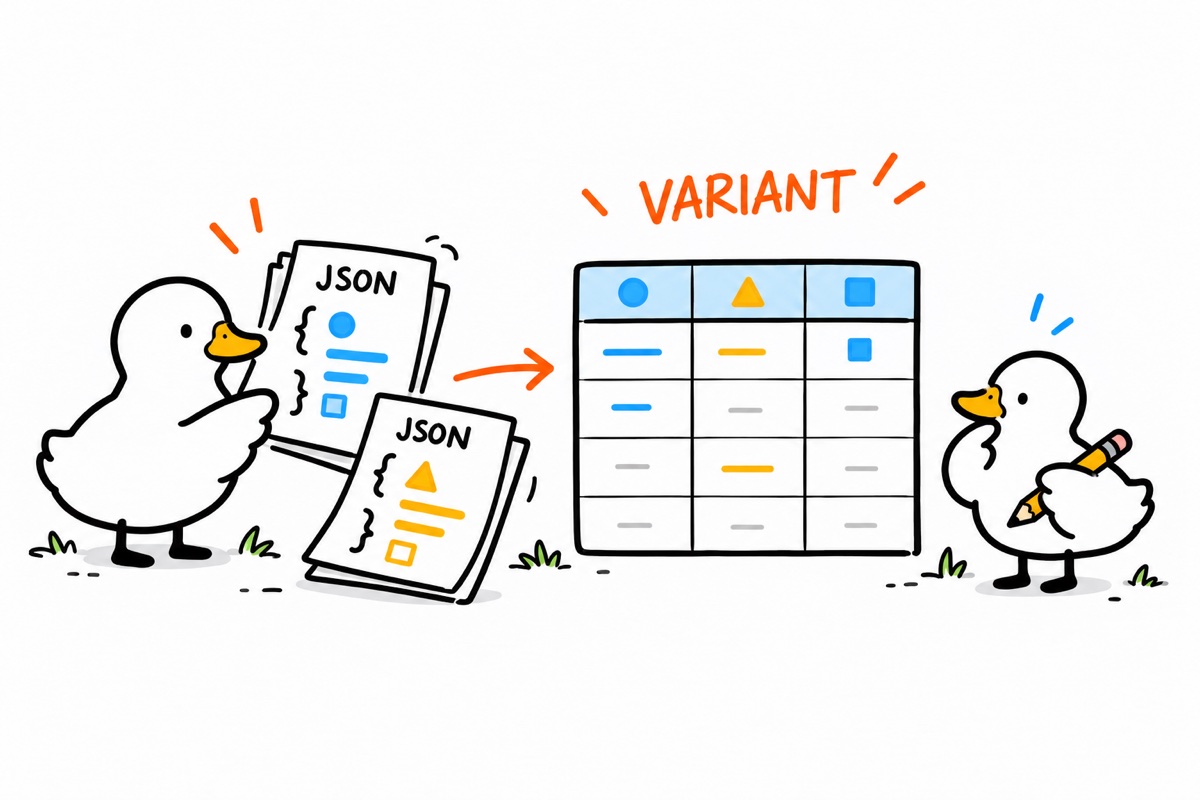
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ Identifica e separa i campi durante la scrittura
eventName(string) | user(string) | success(boolean) ...
Il layout effettivo dipende dalla distribuzione dei dati e dalla codifica.
Alcuni test della community hanno riportato velocizzazioni delle query intorno a 6×, insieme a un'archiviazione sensibilmente più compatta. Quei numeri dipendono dal carico di lavoro.
Per l'analisi di sicurezza, questo apre un percorso dagli eventi CloudTrail grezzi all'analisi dell'attività degli utenti, al rilevamento di chiamate API inusuali e alle indagini sui cambi di permessi senza una pipeline ETL complessa. Una grande piattaforma dati non è sempre il punto di partenza: DuckDB, SQL e un agente AI possono coprire una parte sostanziale di un'indagine.
3. I/O asincrono: local-first può includere dati remoti
I dati spesso risiedono in S3, in altri object store o in un data lake. Con l'I/O sincrono, la latenza di rete può rallentare le query remote. L'I/O asincrono di DuckDB 2.0 consente a più letture di procedere in background mentre i thread di elaborazione delle query lavorano sui dati già arrivati.
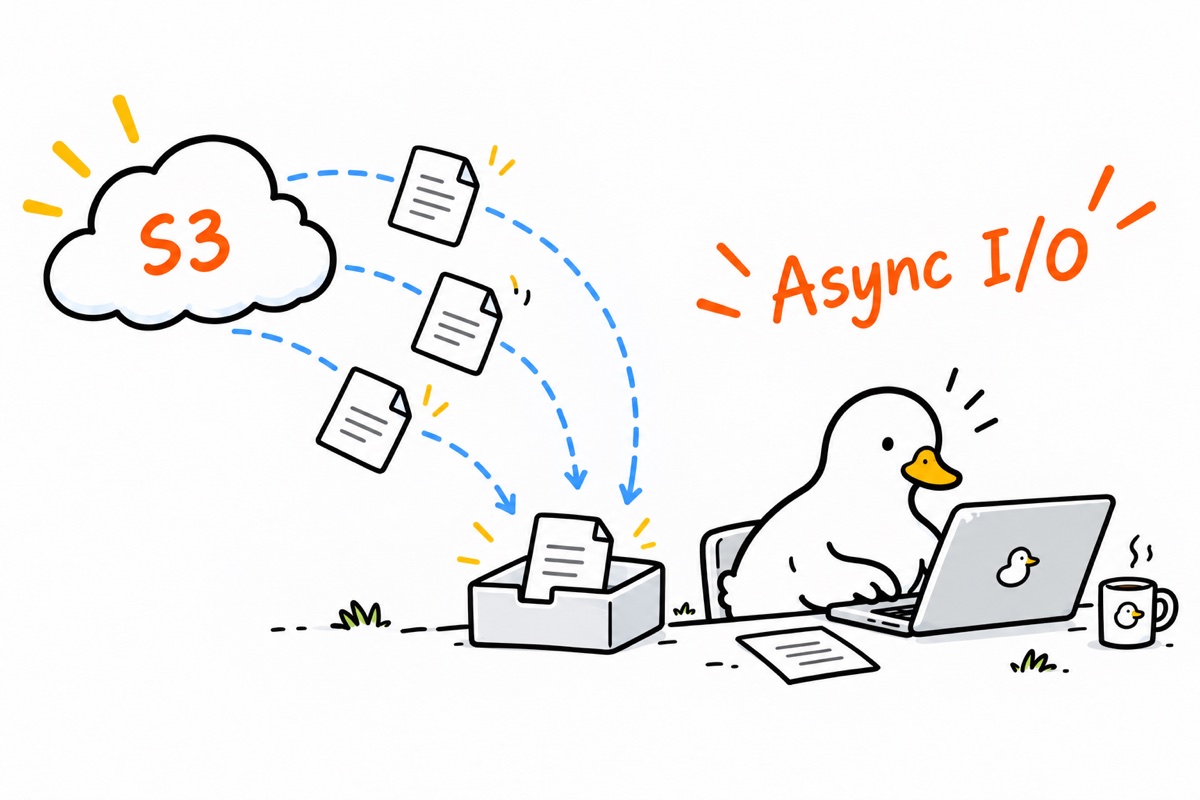
Al momento in cui scrivo, la documentazione sull'I/O elenca il supporto per Parquet e per file CSV UTF-8 non compressi e con seek; JSON e i file nativi di DuckDB risultano ancora basati su I/O sincrono. L'articolo di anteprima della 2.0 menziona anche progressi verso il supporto del formato nativo, quindi verifica le capacità della versione che usi. Documentazione sull'I/O
4. DuckDB come server: oltre un singolo processo
DuckDB è nato come database in-process, incorporato direttamente in applicazioni Python, Rust e C++. Quel modello rende meno comodo condividere un database tra applicazioni o eseguire query in remoto. La versione 2.0 introduce il protocollo Quack e l'istruzione CONNECT, permettendo a DuckDB di funzionare come server e ai client di inviare SQL per l'esecuzione remota. Supporta anche il push down delle query verso database remoti come PostgreSQL e MySQL invece di portare i dati nel processo locale.
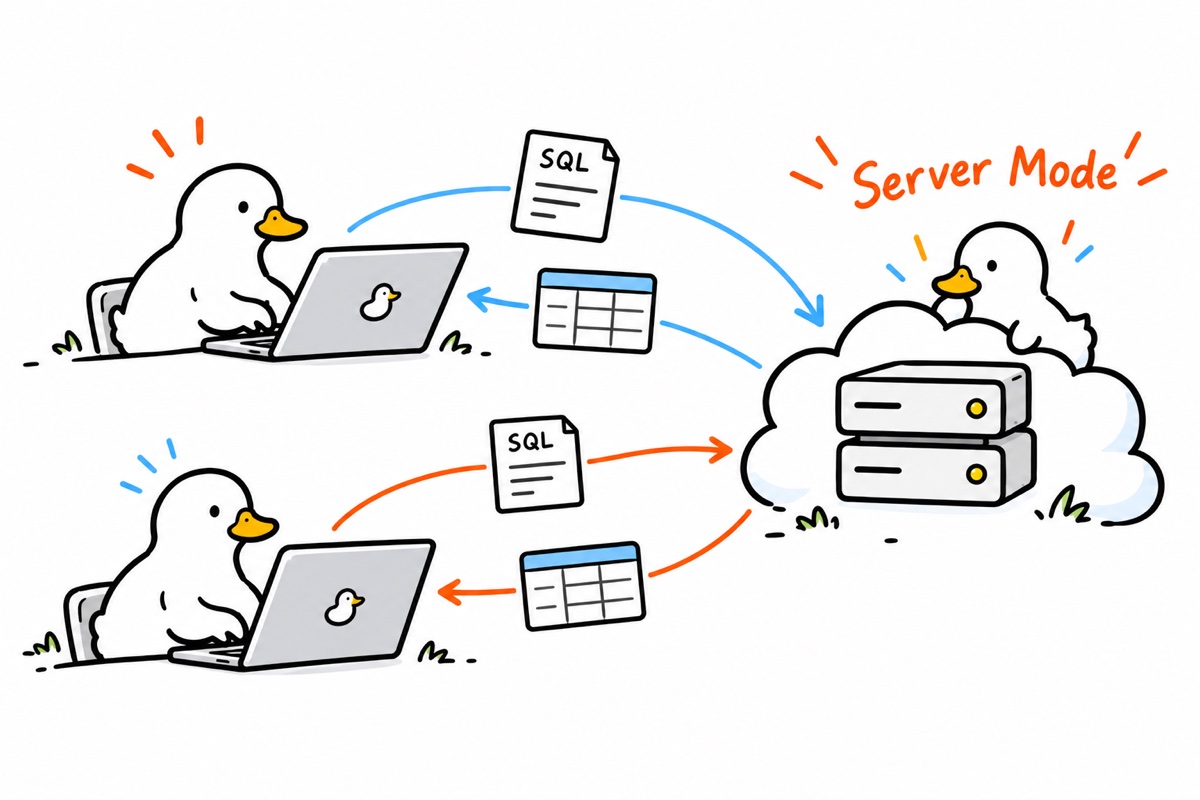
Questo conta per l'uso aziendale: i team hanno bisogno di uno spazio di lavoro condiviso. L'architettura che voglio realizzare avvicina l'AI ai dati, con il calcolo che avviene dove i dati appartengono.
Quack non è di per sé una soluzione aziendale completa per permessi, auditing e multi-tenancy. Questi aspetti richiedono ancora una progettazione a livello applicativo. Ciò che fornisce è una base su cui costruire quell'architettura.
Local-first significa dare agli utenti il controllo sui propri dati e sul proprio calcolo. Non richiede che tutto avvenga localmente.
5. Altre migliorie da tenere d'occhio
- Un motore recursive CTE riscritto. In un test di raggiungibilità su grafo con un milione di archi, il tempo di query è sceso da 4,90 secondi a 0,12 secondi, circa una velocizzazione di 40×. Alcune attività di traversata di grafi diventano più pratiche in SQL, anche se questo non rende DuckDB un sostituto di un database a grafo specializzato.
- Sostituzioni native per le funzionalità di ICU. DuckDB elimina la dipendenza dalla libreria ICU. Nei microbenchmark, la conversione dei fusi orari è risultata circa 2,2× più veloce e il filtraggio con una collation tedesca circa 2,6× più veloce. Un'impronta più ridotta avvantaggia anche le applicazioni incorporate.
- Un'API stabile per le estensioni. Un'API C ridisegnata, un ABI versionato e il supporto per repository di estensioni self-hosted potrebbero ridurre sensibilmente la manutenzione necessaria tra un aggiornamento e l'altro di DuckDB. Questo è particolarmente promettente per chi sviluppa estensioni in Rust.
- Trigger e un parser PEG. I trigger possono supportare auditing ed elaborazione delle modifiche ai dati. Un parser estensibile dà alle estensioni un accesso più profondo al parsing SQL, aprendo potenzialmente la strada a sintassi specifiche di dominio per l'analisi di sicurezza e l'observability.
6. Prima di aggiornare
La versione 2.0 non è del tutto retrocompatibile.
- Formato di archiviazione. I file creati o scritti con il nuovo formato predefinito non possono essere aperti dalle versioni precedenti. Se i lettori più vecchi devono restare supportati, imposta una versione esplicita di compatibilità dell'archiviazione. I database esistenti possono essere esportati e importati seguendo la guida ufficiale alla migrazione.
- Sintassi lambda. La vecchia sintassi è disabilitata per impostazione predefinita. Un'impostazione temporanea di compatibilità può abilitarla, ma la rimozione è prevista per la 2.1.
-- Old
SELECT list_transform([1, 2, 3], x -> x + 1);
-- New
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- Estensioni C++. Verifica che siano disponibili build compatibili prima di aggiornare.
Valida le query esistenti, i file di database e le estensioni di terze parti prima di spostare carichi di lavoro in produzione. Le applicazioni desktop dovrebbero prestare particolare attenzione a non migrare silenziosamente il formato del file di un utente: una versione precedente dell'applicazione potrebbe non riuscire più ad aprirlo. Guida alla migrazione
7. Considerazioni finali
Analizzare un CSV o qualche gigabyte di log spesso inizia con il distribuire un database, configurare pipeline e mantenere servizi. Questo può avere senso per una grande piattaforma dati aziendale, ma non è sempre necessario per singoli sviluppatori, analisti di sicurezza o indagini una tantum.
DuckDB incorpora un motore analitico direttamente in un'applicazione. La versione 2.0 aggiunge la modalità server, Agent Mode e un ecosistema di estensioni più maturo. Il database, l'agente AI e l'interfaccia visuale possono unirsi in uno spazio di lavoro leggero e incorporabile per l'analisi dei dati.
È per questo che sto costruendo DuckLocal, un'app desktop open source e local-first per SQL, dashboard visuali e analisi collaborativa con l'AI. L'AI aiuta a esplorare i dati mentre l'utente mantiene il controllo, l'esecuzione resta ispezionabile e l'SQL rimane trasparente.
Riferimenti
Al 19 ottobre 2026, DuckDB 2.0 non è ancora stato rilasciato. La data di rilascio e i dettagli delle funzionalità restano soggetti all'annuncio ufficiale finale.