 DuckLocal
DuckDB 2.0, nom de code Cyanoptera, est prévu pour le 21 octobre 2026. À peine sept mois après la version 1.5 de mars, le projet a accumulé plus de 10 000 commits.
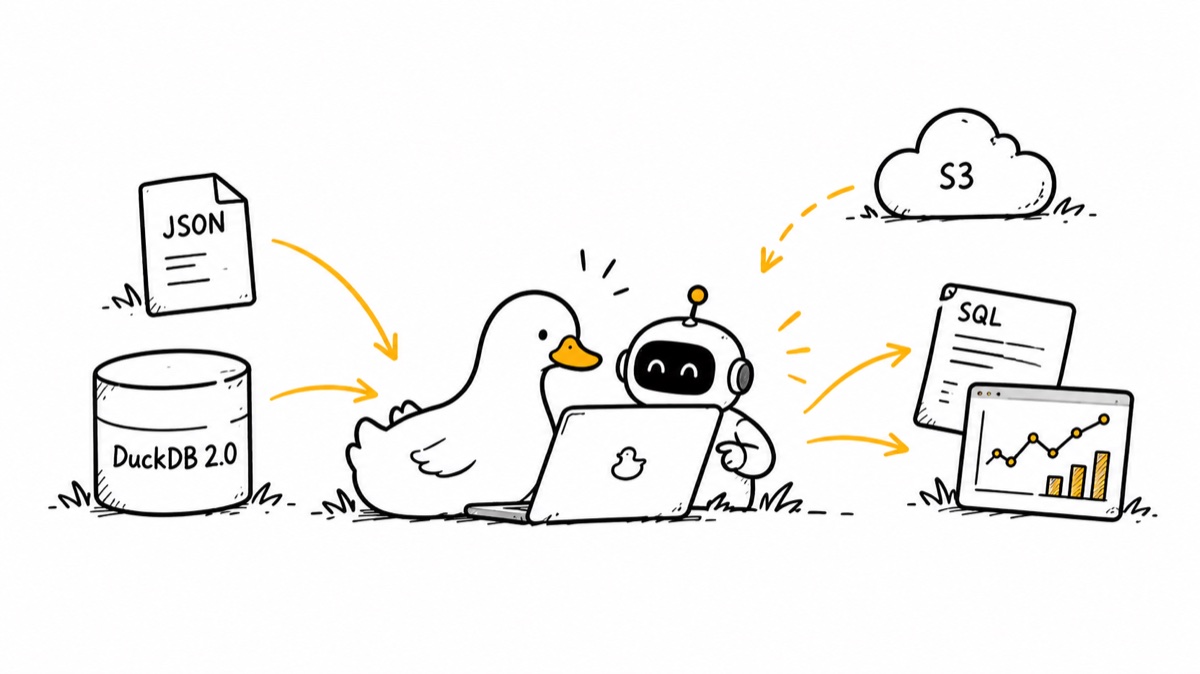
La nouvelle version apporte un nouveau format de stockage, un parseur SQL, les E/S asynchrones et une prise en charge plus complète de VARIANT, ainsi que le mode serveur et un Agent Mode en CLI conçu pour les agents IA. À mes yeux, l'histoire intéressante dépasse la vitesse d'exécution d'une requête : DuckDB est en train de changer ce que peut être un outil d'analyse de données.
J'ai passé une grande partie de ma carrière dans l'SRE, l'observabilité et l'analyse de sécurité. Plus récemment, je développe DuckLocal, un outil d'analyse local-first open source propulsé par DuckDB. Je vois de plus en plus un avenir où l'analyse est une collaboration entre humains et agents IA, plutôt qu'une personne qui ouvre un outil BI pour écrire du SQL et configurer des tableaux de bord. Plusieurs changements de DuckDB 2.0 vont dans cette direction.
1. Agent Mode : traiter les agents comme des utilisateurs de la base de données
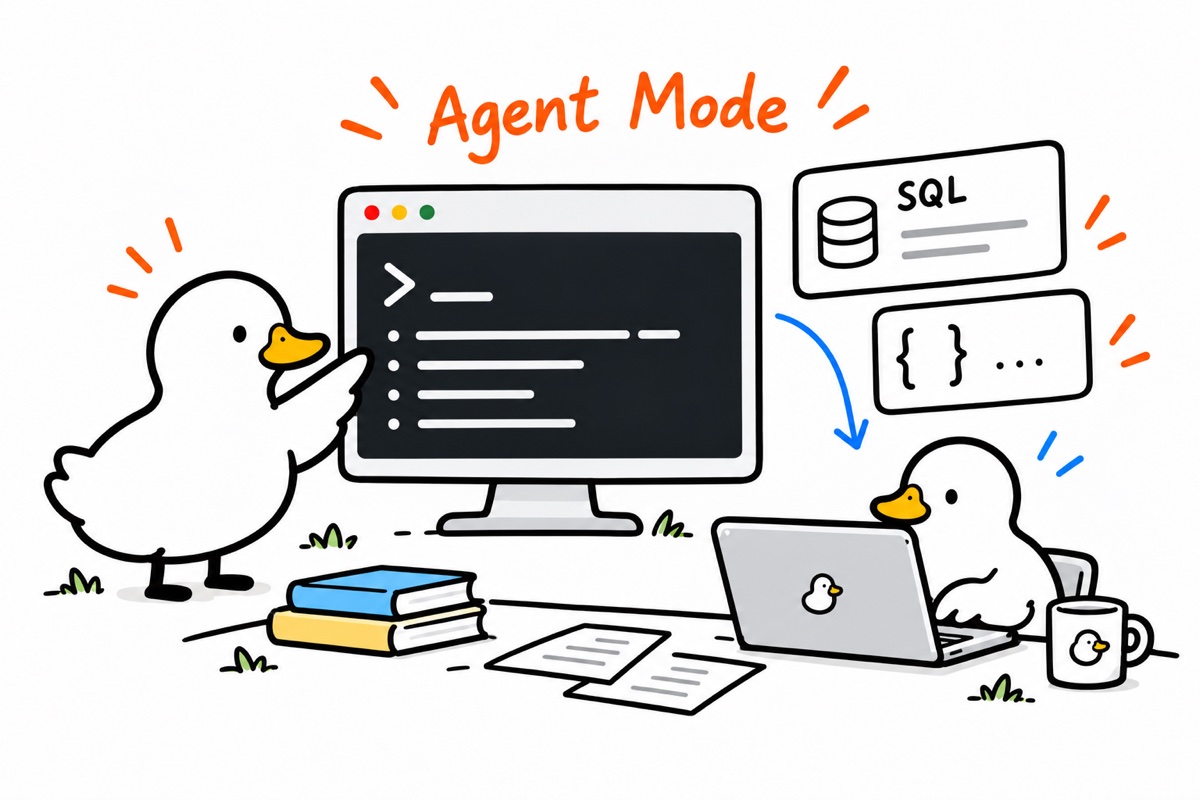
Les interfaces en ligne de commande classiques sont conçues pour les humains. Les bordures et les espaces d'alignement d'un tableau de la CLI DuckDB sont peu utiles à un agent. Le remplissage consomme des jetons ; un résultat tronqué peut sembler complet ; les erreurs manquent parfois de structure ; et une requête longue peut laisser l'agent attendre sans retour utile.
Agent Mode détecte des environnements comme Claude Code et Codex et adapte automatiquement la sortie. Il utilise des tableaux Markdown compacts, des avis de troncature explicites et des erreurs au format JSON, et fournit un retour sur les requêtes longues.
Dans une expérience officielle, Claude Code a répondu aux 22 questions TPC-H à partir d'invites en langage naturel. Chaque question a été exécutée trois fois dans chaque mode, soit 132 exécutions au total, et chaque exécution a produit la bonne réponse. La sortie DuckDB lue par le modèle est passée de 123,6 k à 50,8 k de jetons, soit une réduction d'environ 59 %. Cela mesure les économies sur la sortie de requête, pas une réduction de 59 % du coût total de la tâche. Le rapport situe ces économies à environ 0,5 % de l'entrée totale et ne constate aucune réduction du coût global ni du temps d'exécution. Expérience et explication
Les discussions sur les agents qui utilisent des bases de données portent souvent sur la précision du text-to-SQL. La facilité et la fiabilité avec lesquelles un agent interagit avec la base de données comptent tout autant.
2. VARIANT : des données flexibles avec moins de compromis sur les performances
Les événements CloudTrail, les journaux applicatifs et les données OpenTelemetry arrivent souvent sous forme de JSON aux structures variables. Dans CloudTrail, par exemple, la forme de requestParameters peut être complètement différente d'un événement à l'autre.
Deux approches sont bien connues : stocker les enregistrements sous forme de chaînes et les analyser à chaque requête, ce qui est flexible mais lent ; ou définir un schéma et répartir les données en colonnes, ce qui est rapide mais rend l'évolution du schéma plus coûteuse. VARIANT vise à combiner ces avantages. Il préserve la souplesse de la structure tout en s'appuyant sur le shredding pour isoler les champs pertinents dans des sous-colonnes distinctes. VARIANT est arrivé en 1.5 ; la version 2.0 étend sa prise en charge du stockage jusqu'à l'exécution des requêtes.
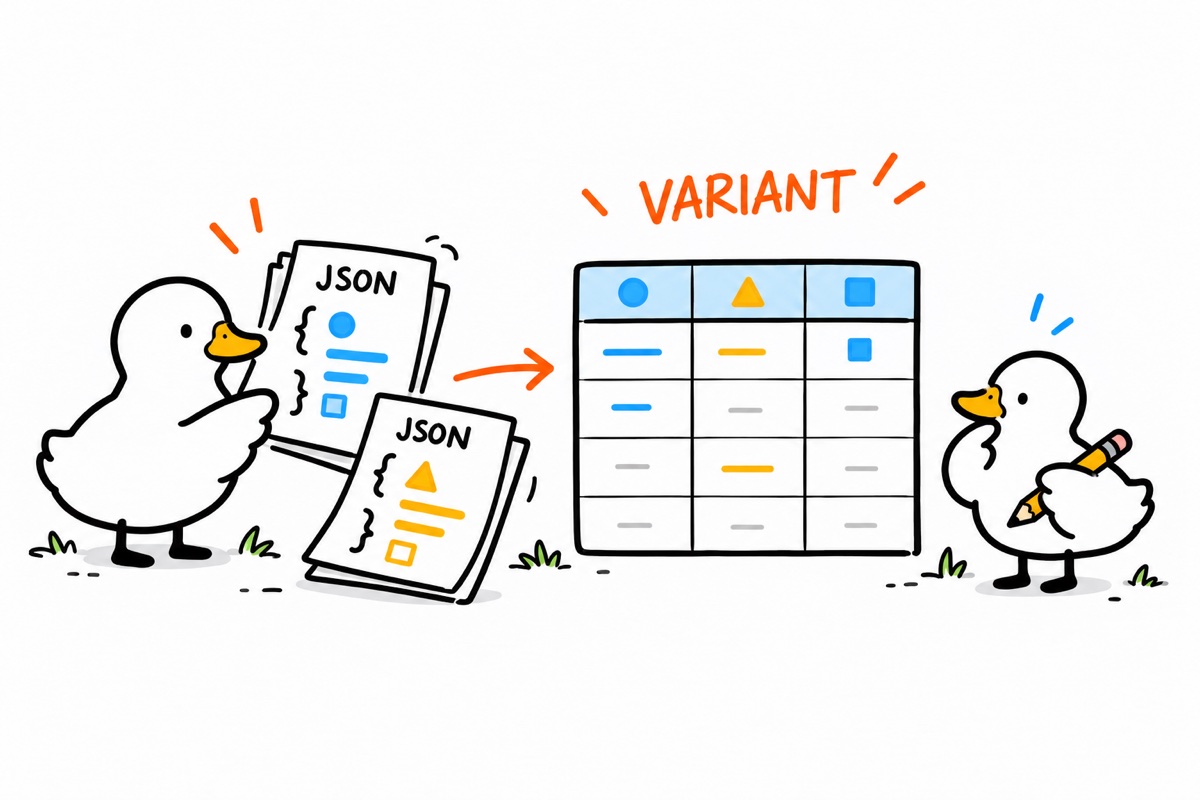
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ Identifier et séparer les champs au moment de l'écriture
eventName(string) | user(string) | success(boolean) ...
La disposition réelle dépend de la distribution des données et de l'encodage.
Certains tests de la communauté rapportent des requêtes environ 6× plus rapides, avec un stockage nettement plus petit. Ces chiffres dépendent de la charge de travail.
Pour l'analyse de sécurité, cela ouvre un chemin allant des événements CloudTrail bruts à l'analyse de l'activité des utilisateurs, à la détection d'appels d'API inhabituels et aux investigations sur les changements de permissions, sans pipeline ETL complexe. Une grande plateforme de données n'est pas toujours le point de départ : DuckDB, SQL et un agent IA peuvent couvrir une bonne partie d'une investigation.
3. E/S asynchrones : le local-first peut inclure des données distantes
Les données vivent souvent dans S3, dans d'autres stockages d'objets ou dans un lac de données. Avec des E/S synchrones, la latence réseau peut bloquer les requêtes distantes. Les E/S asynchrones de DuckDB 2.0 permettent de lancer plusieurs lectures en arrière-plan pendant que les threads de traitement des requêtes travaillent sur les données déjà arrivées.
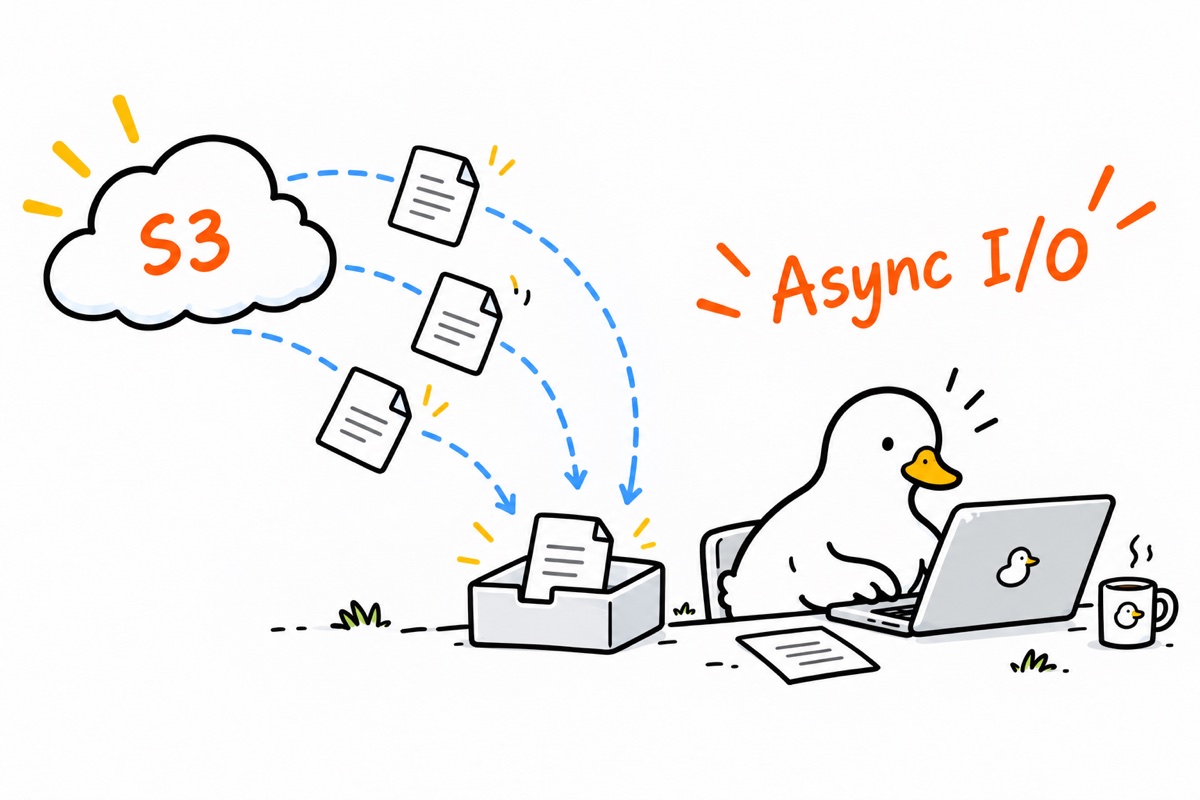
Au moment de la rédaction, la documentation des E/S mentionne la prise en charge des fichiers Parquet et des fichiers CSV UTF-8 non compressés et adressables ; les fichiers JSON et les fichiers natifs DuckDB sont encore indiqués comme utilisant des E/S synchrones. L'article de prévisualisation de la 2.0 évoque aussi des progrès vers la prise en charge du format natif : vérifiez les capacités de la version que vous utilisez. Documentation des E/S
4. DuckDB comme serveur : au-delà d'un seul processus
DuckDB a commencé comme une base de données in-process, intégrée directement dans des applications Python, Rust et C++. Ce modèle rend moins pratique le partage d'une base entre plusieurs applications ou l'exécution de requêtes à distance. La version 2.0 introduit le protocole Quack et l'instruction CONNECT, ce qui permet à DuckDB de fonctionner comme serveur et aux clients d'envoyer du SQL pour une exécution distante. Il prend aussi en charge la poussée de requêtes vers des bases distantes comme PostgreSQL et MySQL, au lieu de rapatrier les données dans le processus local.
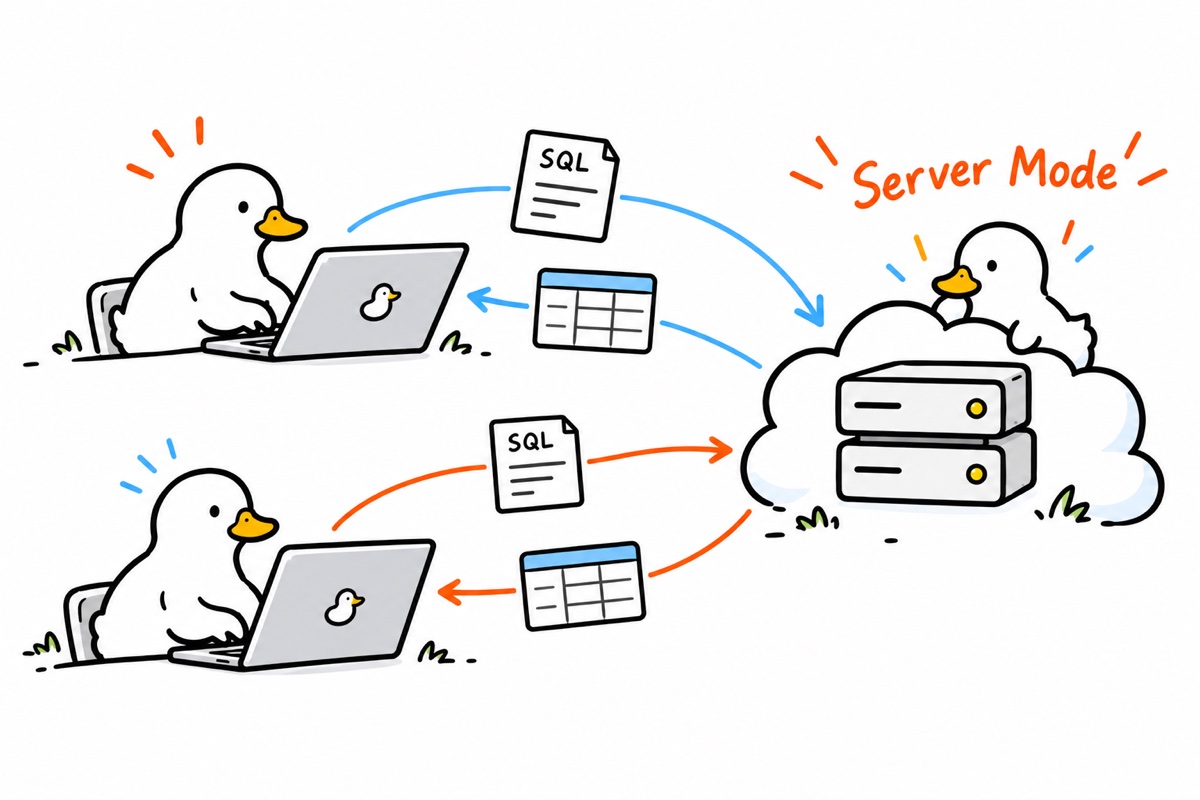
Cela compte pour un usage en entreprise : les équipes ont besoin d'un espace de travail partagé. L'architecture que je veux rapproche l'IA des données, avec un calcul qui s'exécute là où les données vivent.
Quack n'est pas, en soi, une solution d'entreprise complète pour les permissions, l'audit et le multi-tenant. Ces sujets demandent encore une conception applicative. Ce que Quack fournit, c'est une base pour construire cette architecture.
Le local-first, c'est donner aux utilisateurs le contrôle de leurs données et de leurs calculs. Cela n'impose pas que tout se passe en local.
5. D'autres améliorations à suivre
- Un moteur de CTE récursif réécrit. Dans un test d'atteignabilité sur un graphe d'un million d'arêtes, le temps de requête est passé de 4,90 secondes à 0,12 seconde, soit environ 40× plus rapide. Certaines tâches de parcours de graphe deviennent plus pratiques en SQL, même si cela ne fait pas de DuckDB un remplacement d'une base de données orientée graphe spécialisée.
- Des remplacements natifs des fonctions ICU. DuckDB supprime sa dépendance à la bibliothèque ICU. Dans les microbenchmarks, la conversion de fuseau horaire est environ 2,2× plus rapide et le filtrage avec un collationnement allemand environ 2,6× plus rapide. Une empreinte plus faible profite aussi aux applications embarquées.
- Une API d'extension stable. Une API C repensée, une ABI versionnée et la prise en charge de dépôts d'extensions auto-hébergés pourraient réduire nettement la maintenance nécessaire au fil des mises à niveau de DuckDB. C'est particulièrement prometteur pour les développeurs d'extensions Rust.
- Des triggers et un parseur PEG. Les triggers peuvent servir à l'audit et au traitement des changements de données. Un parseur extensible donne aux extensions un accès plus profond à l'analyse SQL, ce qui ouvre peut-être la voie à une syntaxe métier pour l'analyse de sécurité et l'observabilité.
6. Avant de mettre à niveau
La version 2.0 n'est pas entièrement rétrocompatible.
- Format de stockage. Les fichiers créés ou écrits avec le nouveau format par défaut ne peuvent pas être ouverts par les versions antérieures. Si d'anciens lecteurs doivent rester pris en charge, définissez explicitement une version de compatibilité du stockage. Les bases existantes peuvent être exportées et importées en suivant les recommandations officielles de migration.
- Syntaxe lambda. L'ancienne syntaxe est désactivée par défaut. Un paramètre de compatibilité temporaire permet de l'activer, mais sa suppression est prévue pour la 2.1.
-- Old
SELECT list_transform([1, 2, 3], x -> x + 1);
-- New
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- Extensions C++. Vérifiez que des builds compatibles sont disponibles avant de mettre à niveau.
Validez les requêtes existantes, les fichiers de base de données et les extensions tierces avant de déplacer des charges de production. Les applications de bureau doivent particulièrement veiller à ne pas migrer silencieusement le format de fichier d'un utilisateur : une version plus ancienne de l'application pourrait ne plus pouvoir l'ouvrir. Guide de migration
7. En guise de conclusion
Analyser un CSV ou quelques gigaoctets de journaux commence souvent par déployer une base de données, configurer des pipelines et maintenir des services. Cela peut se justifier pour une grande plateforme de données d'entreprise, mais ce n'est pas toujours nécessaire pour un développeur indépendant, un analyste sécurité ou une investigation ponctuelle.
DuckDB intègre un moteur analytique directement dans une application. La version 2.0 ajoute le mode serveur, Agent Mode et un écosystème d'extensions plus mature. La base de données, l'agent IA et l'interface visuelle peuvent former ensemble un espace de travail d'analyse léger et embarquable.
C'est pourquoi je développe DuckLocal, une application de bureau open source et local-first pour le SQL, les tableaux de bord visuels et l'analyse collaborative avec l'IA. L'IA aide à explorer les données, l'utilisateur garde le contrôle, l'exécution reste inspectable et le SQL reste transparent.
Références
Au 19 octobre 2026, DuckDB 2.0 n'est pas encore publié. La date de sortie et les détails des fonctionnalités restent soumis à l'annonce officielle finale.