 DuckLocal
DuckDB 2.0, con el nombre en clave Cyanoptera, está previsto para el 21 de octubre de 2026. Solo siete meses después del lanzamiento de la 1.5 en marzo, el proyecto ha acumulado más de 10,000 commits.
La nueva versión trae un formato de almacenamiento nuevo, un analizador de SQL nuevo, E/S asíncrona y un soporte de VARIANT más completo, además del modo servidor y un Agent Mode para la CLI pensado para agentes de IA. Para mí, la historia interesante va más allá de cuánto más rápida puede ser una consulta concreta: DuckDB está cambiando el aspecto que puede tener una herramienta de análisis de datos.
He pasado buena parte de mi carrera trabajando en SRE, observabilidad y análisis de seguridad. Más recientemente he estado construyendo DuckLocal, una herramienta de análisis local-first y de código abierto impulsada por DuckDB. Cada vez veo más claro un futuro en el que el análisis es una colaboración entre personas y agentes de IA, en lugar de una persona abriendo una herramienta de BI para escribir SQL y configurar paneles. Varios cambios de DuckDB 2.0 encajan en esa dirección.
1. Agent Mode: tratar a los agentes como usuarios de la base de datos
Las interfaces de línea de comandos tradicionales están pensadas para personas. Los bordes y los espacios de alineación de una tabla de la CLI de DuckDB son menos útiles para un agente. El relleno consume tokens; un resultado truncado puede parecer completo; a los errores les puede faltar estructura; y una consulta larga puede dejar al agente esperando sin información útil.
Agent Mode detecta entornos como Claude Code y Codex y ajusta la salida automáticamente. Usa tablas Markdown compactas, avisos explícitos de truncamiento y errores en JSON, y da información sobre el avance de las consultas largas.
En un experimento oficial, Claude Code respondió a las 22 preguntas de TPC-H a partir de instrucciones en lenguaje natural. Cada pregunta se ejecutó tres veces en cada modo, 132 ejecuciones en total, y todas dieron la respuesta correcta. La salida de DuckDB que leía el modelo bajó de 123.6K a 50.8K tokens, una reducción de alrededor del 59%. Eso mide el ahorro en la salida de las consultas, no una reducción del 59% en el coste total de la tarea. El informe sitúa el ahorro en torno al 0.5% de la entrada total y no encontró ninguna reducción del coste ni del tiempo de ejecución. Experimento y explicación
Las conversaciones sobre agentes que usan bases de datos suelen centrarse en la precisión del text-to-SQL. La eficiencia y la fiabilidad con las que un agente puede interactuar con la base de datos importan igual.
2. VARIANT: datos flexibles con menos concesiones de rendimiento
Los eventos de CloudTrail, los logs de las aplicaciones y los datos de OpenTelemetry suelen llegar como JSON con estructuras variables. En CloudTrail, por ejemplo, la forma de requestParameters puede ser completamente distinta de un evento a otro.
Hay dos enfoques conocidos: guardar los registros como cadenas y analizarlos una y otra vez en el momento de la consulta, lo que es flexible pero lento; o definir un esquema y dividir los datos en columnas, lo que es rápido pero hace que la evolución del esquema cueste más. VARIANT pretende combinar ambas ventajas. Conserva la estructura flexible y usa el shredding para separar los campos adecuados en subcolumnas individuales. VARIANT llegó en la 1.5; la versión 2.0 amplía su soporte desde el almacenamiento hasta la ejecución de las consultas.
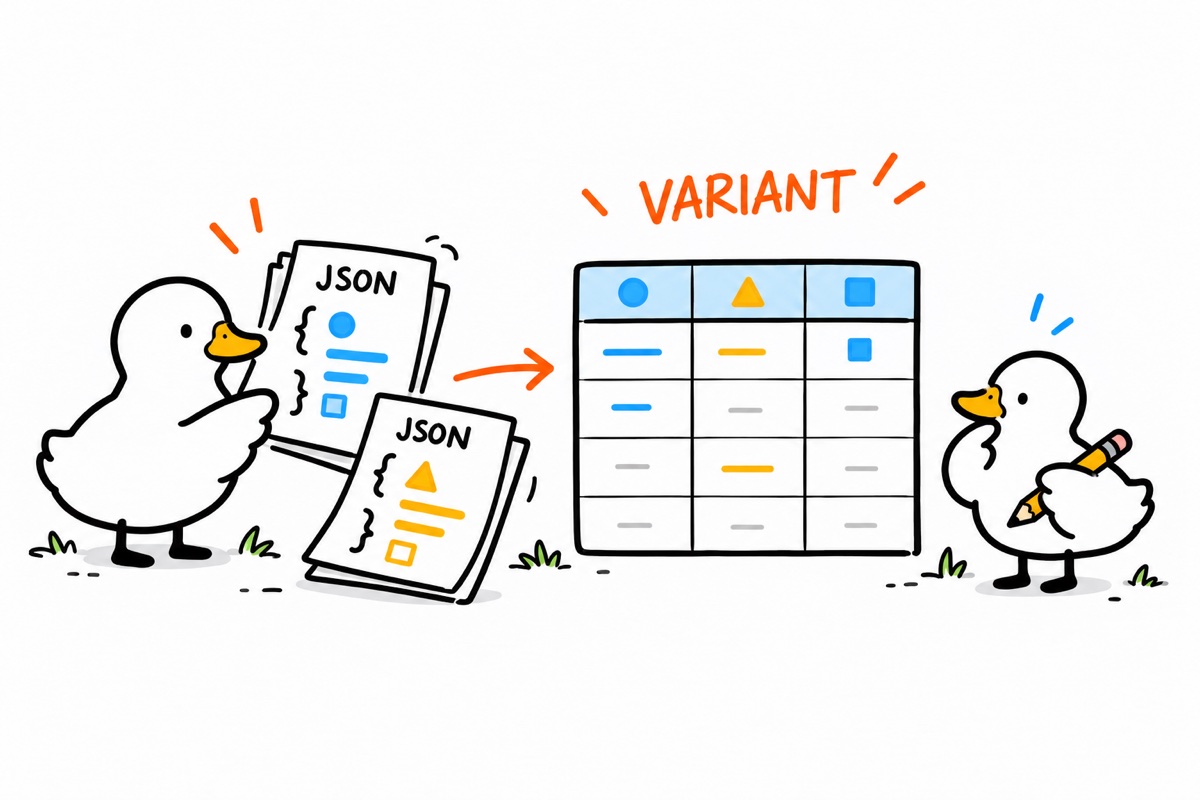
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ Identifica y separa los campos durante la escritura
eventName(string) | user(string) | success(boolean) ...
La disposición real depende de la distribución de los datos y de la codificación.
Algunas pruebas de la comunidad han reportado consultas unas 6× más rápidas, junto con un almacenamiento bastante menor. Esas cifras dependen de la carga de trabajo.
Para el análisis de seguridad, esto abre un camino que va de los eventos brutos de CloudTrail al análisis de la actividad de los usuarios, la detección de llamadas a la API inusuales y la investigación de cambios de permisos sin un pipeline ETL complejo. Una gran plataforma de datos no siempre es el punto de partida: DuckDB, SQL y un agente de IA pueden cubrir una parte importante de una investigación.
3. E/S asíncrona: local-first también puede incluir datos remotos
Los datos suelen vivir en S3, en otros almacenes de objetos o en un data lake. Con E/S síncrona, la latencia de red puede frenar las consultas remotas. La E/S asíncrona de DuckDB 2.0 permite que varias lecturas se ejecuten en segundo plano mientras los hilos de procesamiento de consultas trabajan con los datos que ya han llegado.
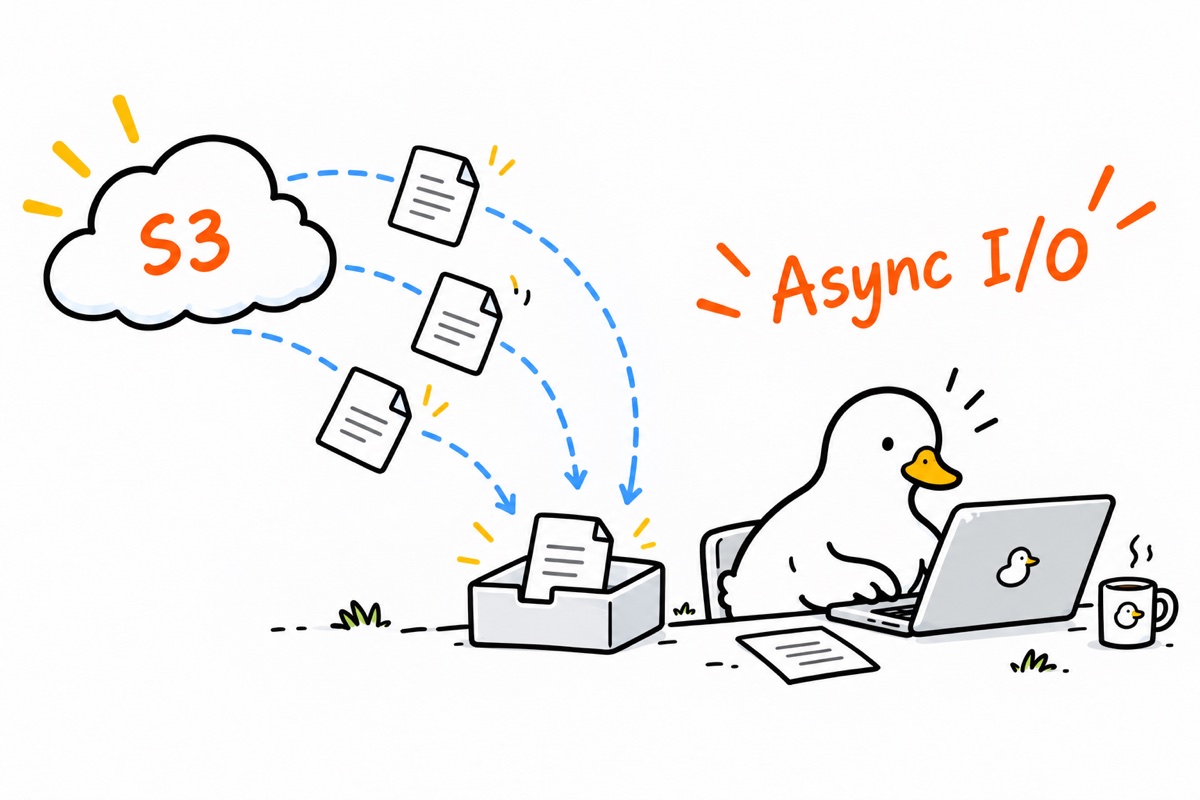
En el momento de escribir esto, la documentación de E/S indica soporte para Parquet y para archivos CSV UTF-8 sin comprimir y con búsqueda; JSON y los archivos nativos de DuckDB siguen apareciendo con E/S síncrona. El artículo de avance de la 2.0 también menciona avances hacia el soporte del formato nativo, así que comprueba las capacidades de la versión que uses. Documentación de E/S
4. DuckDB como servidor: más allá de un solo proceso
DuckDB empezó como una base de datos en proceso, embebida directamente en aplicaciones Python, Rust y C++. Ese modelo hace menos cómodo compartir una base de datos entre aplicaciones o ejecutar consultas en remoto. La versión 2.0 introduce el protocolo Quack y la sentencia CONNECT, que permiten ejecutar DuckDB como servidor y que los clientes envíen SQL para ejecutarlo en remoto. También permite empujar consultas a bases de datos remotas como PostgreSQL y MySQL en lugar de traer los datos al proceso local.
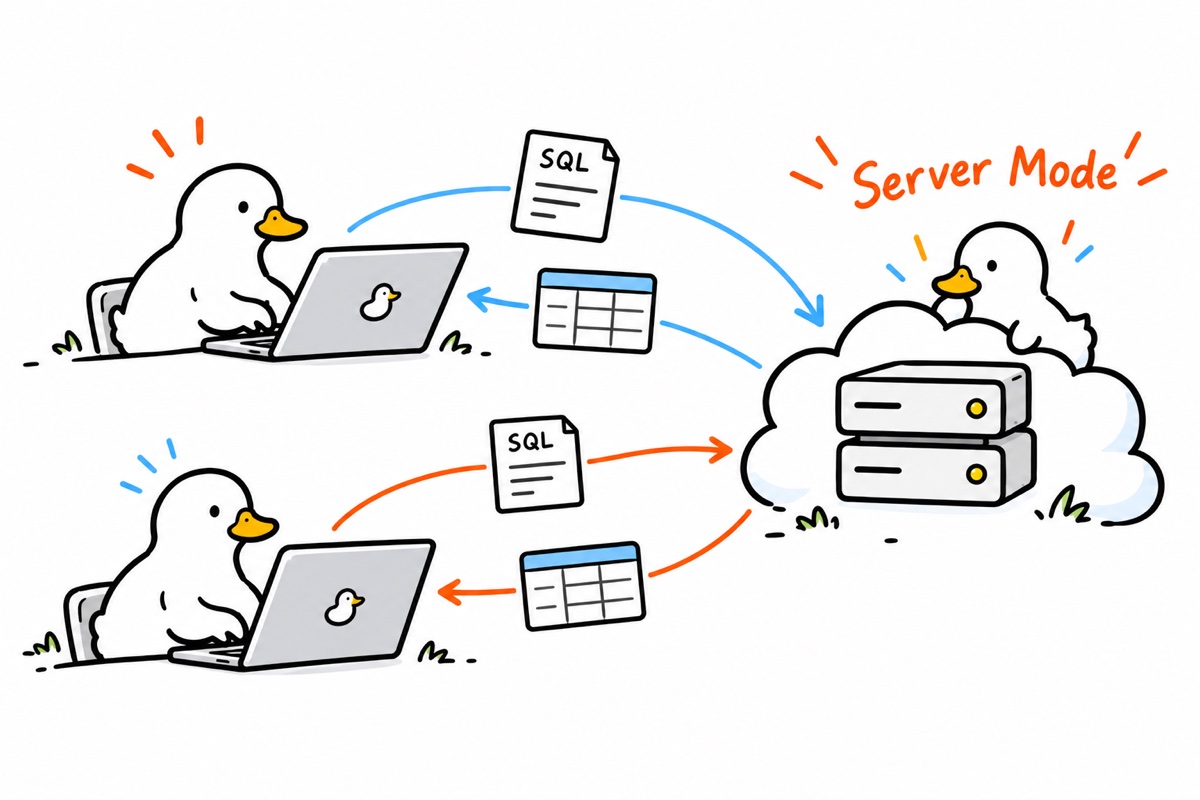
Eso importa para el uso empresarial: los equipos necesitan un espacio de trabajo compartido. La arquitectura que quiero lleva la IA más cerca de los datos, con el cómputo ejecutándose donde pertenecen los datos.
Quack no es, por sí solo, una solución empresarial completa para permisos, auditoría y multitenencia. Todo eso sigue necesitando un diseño a nivel de aplicación. Lo que aporta es una base sobre la que construir esa arquitectura.
Local-first significa dar a los usuarios el control de sus datos y de su cómputo. No exige que todo ocurra en local.
5. Otras mejoras que merece la pena seguir
- Un motor de CTE recursivas reescrito. En una prueba de alcanzabilidad en grafos con un millón de aristas, el tiempo de consulta bajó de 4.90 segundos a 0.12 segundos, unas 40× más rápido. Algunas tareas de recorrido de grafos se vuelven más prácticas en SQL, aunque esto no convierte a DuckDB en un sustituto de una base de datos de grafos especializada.
- Sustitutos nativos de la funcionalidad de ICU. DuckDB elimina su dependencia de la biblioteca ICU. En microbenchmarks, la conversión de zonas horarias fue unas 2.2× más rápida y el filtrado con una colación alemana unas 2.6× más rápida. Una huella menor también beneficia a las aplicaciones embebidas.
- Una API de extensiones estable. Una API de C rediseñada, un ABI versionado y el soporte de repositorios de extensiones autohospedados podrían reducir sustancialmente el mantenimiento necesario entre actualizaciones de DuckDB. Es especialmente prometedor para quienes desarrollan extensiones en Rust.
- Triggers y un analizador PEG. Los triggers pueden dar soporte a la auditoría y al procesamiento de cambios en los datos. Un analizador extensible da a las extensiones un acceso más profundo al análisis de SQL, lo que puede abrir la puerta a sintaxis específicas de dominio para el análisis de seguridad y la observabilidad.
6. Antes de actualizar
La versión 2.0 no es del todo retrocompatible.
- Formato de almacenamiento. Los archivos creados o escritos con el nuevo formato predeterminado no se pueden abrir con versiones anteriores. Si hay que seguir dando soporte a lectores antiguos, define una versión de compatibilidad de almacenamiento explícita. Las bases de datos existentes se pueden exportar e importar siguiendo la guía oficial de migración.
- Sintaxis lambda. La sintaxis antigua está desactivada por defecto. Un ajuste de compatibilidad temporal permite activarla, pero su eliminación está prevista para la 2.1.
-- Old
SELECT list_transform([1, 2, 3], x -> x + 1);
-- New
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- Extensiones de C++. Comprueba que haya compilaciones compatibles disponibles antes de actualizar.
Valida las consultas existentes, los archivos de base de datos y las extensiones de terceros antes de mover cargas de trabajo de producción. Las aplicaciones de escritorio deberían tener un cuidado especial en no migrar en silencio el formato de archivo de un usuario: puede que una versión anterior de la aplicación ya no pueda abrirlo. Guía de migración
7. Conclusión
Analizar un CSV o unos pocos gigabytes de logs a menudo empieza por desplegar una base de datos, configurar pipelines y mantener servicios. Eso puede tener sentido para una gran plataforma de datos empresarial, pero no siempre es necesario para desarrolladores individuales, analistas de seguridad o investigaciones puntuales.
DuckDB embebe un motor analítico directamente en una aplicación. La versión 2.0 añade el modo servidor, Agent Mode y un ecosistema de extensiones más maduro. La base de datos, el agente de IA y la interfaz visual pueden unirse en un espacio de trabajo para el análisis de datos ligero y embebible.
Por eso estoy construyendo DuckLocal, una aplicación de escritorio de código abierto y local-first para SQL, paneles visuales y análisis colaborativo con IA. La IA ayuda a explorar los datos mientras el usuario mantiene el control, la ejecución sigue siendo inspeccionable y el SQL se mantiene transparente.
Referencias
A 19 de octubre de 2026, DuckDB 2.0 todavía no se ha publicado. La fecha de lanzamiento y los detalles de las funciones quedan sujetos al anuncio oficial final.