 DuckLocal
DuckDB 2.0 mit dem Codenamen Cyanoptera soll am 21. Oktober 2026 erscheinen. Nur sieben Monate nach dem 1.5-Release im März hat das Projekt mehr als 10.000 Commits angesammelt.
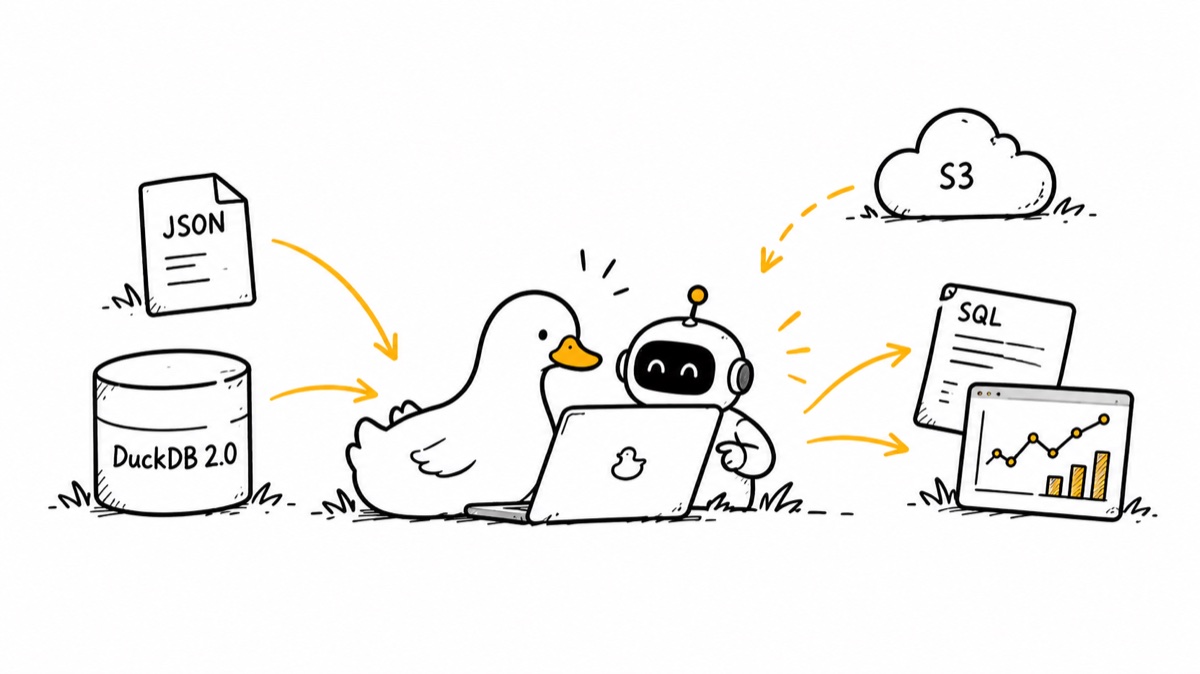
Die neue Version bringt ein neues Speicherformat, einen neuen SQL-Parser, asynchrones I/O und eine vollständigere VARIANT-Unterstützung, dazu einen Server-Modus und einen CLI-Agent-Mode für KI-Agenten. Für mich liegt die spannende Geschichte jenseits der Frage, wie viel schneller eine einzelne Abfrage läuft: DuckDB verändert, wie ein Werkzeug zur Datenanalyse aussehen kann.
Einen großen Teil meiner Laufbahn habe ich in SRE, Observability und Security-Analytics gearbeitet. In letzter Zeit baue ich DuckLocal, ein Open-Source-Analysewerkzeug nach dem Local-first-Prinzip auf Basis von DuckDB. Ich sehe immer deutlicher eine Zukunft, in der Analyse eine Zusammenarbeit von Menschen und KI-Agenten ist, statt dass eine Person ein BI-Tool öffnet, SQL schreibt und Dashboards konfiguriert. Mehrere Änderungen in DuckDB 2.0 passen in diese Richtung.
1. Agent Mode: Agenten als Datenbanknutzer behandeln
Klassische Kommandozeilen-Oberflächen sind für Menschen gemacht. Rahmen und Ausrichtungs-Leerzeichen in einer Tabelle der DuckDB CLI helfen einem Agenten wenig. Padding kostet Token, ein abgeschnittenes Ergebnis kann vollständig aussehen, Fehlern fehlt oft die Struktur, und bei einer langen Abfrage wartet der Agent ohne brauchbares Feedback.
Agent Mode erkennt Umgebungen wie Claude Code und Codex und passt die Ausgabe automatisch an. Er nutzt kompakte Markdown-Tabellen, ausdrückliche Hinweise auf Kürzungen und JSON-Fehler und gibt bei lange laufenden Abfragen Rückmeldung.
In einem offiziellen Experiment beantwortete Claude Code alle 22 TPC-H-Fragen aus Prompts in natürlicher Sprache. Jede Frage lief in jedem Modus dreimal, insgesamt 132 Läufe, und jeder Lauf lieferte die richtige Antwort. Die DuckDB-Ausgabe, die das Modell las, sank von 123.6K auf 50.8K Token, eine Verringerung um rund 59 %. Das misst die Einsparung bei der Abfrageausgabe, nicht eine Senkung der Gesamtkosten der Aufgabe um 59 %. Der Bericht beziffert die Einsparung auf etwa 0.5 % des gesamten Inputs und fand keine Verringerung von Gesamtkosten oder Laufzeit. Experiment und Erläuterung
Wenn es um Agenten und Datenbanken geht, dreht sich die Diskussion oft um die Genauigkeit von Text-to-SQL. Wie effizient und zuverlässig ein Agent mit der Datenbank interagiert, ist genauso wichtig.
2. VARIANT: flexible Daten mit weniger Kompromissen bei der Leistung
CloudTrail-Events, Anwendungslogs und OpenTelemetry-Daten kommen oft als JSON mit unterschiedlicher Struktur an. In CloudTrail kann die Form von requestParameters von einem Event zum nächsten völlig anders aussehen.
Es gibt zwei bekannte Wege: die Datensätze als Strings speichern und bei jeder Abfrage neu parsen, das ist flexibel, aber langsam; oder ein Schema definieren und die Daten in Spalten aufteilen, das ist schnell, macht aber Schemaänderungen aufwendig. VARIANT will beide Vorteile verbinden. Die flexible Struktur bleibt erhalten, während Shredding geeignete Felder in eigene Unterspalten auslagert. VARIANT kam mit 1.5; Version 2.0 dehnt die Unterstützung von der Speicherung bis zur Abfrageausführung aus.
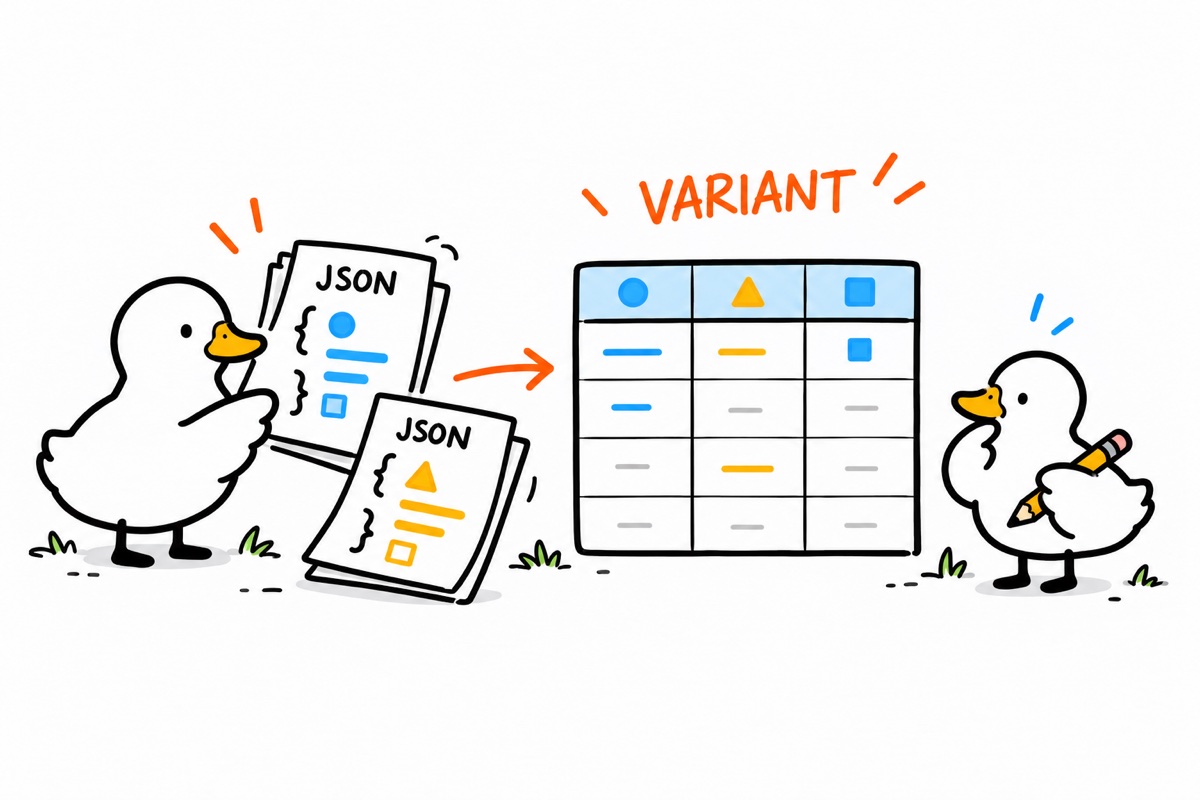
{"eventName":"ConsoleLogin","user":"alice","success":true}
{"eventName":"CreateUser","user":"bob","sourceIP":"10.0.0.8"}
↓ Felder beim Schreiben erkennen und trennen
eventName(string) | user(string) | success(boolean) ...
Das tatsächliche Layout hängt von der Datenverteilung und der Kodierung ab.
Einige Tests aus der Community berichten von etwa 6× schnelleren Abfragen bei deutlich kleinerem Speicherbedarf. Diese Zahlen hängen von der Arbeitslast ab.
Für Security-Analytics eröffnet das einen Weg von rohen CloudTrail-Events zur Analyse von Nutzeraktivität, zum Erkennen ungewöhnlicher API-Aufrufe und zur Untersuchung von Berechtigungsänderungen, ohne komplexe ETL-Pipeline. Eine große Datenplattform ist nicht immer der Ausgangspunkt: DuckDB, SQL und ein KI-Agent können einen wesentlichen Teil einer Untersuchung tragen.
3. Asynchrones I/O: Local-first schließt entfernte Daten ein
Daten liegen oft in S3, in anderen Objektspeichern oder in einem Data Lake. Bei synchronem I/O kann die Netzwerklatenz entfernte Abfragen ausbremsen. Das asynchrone I/O von DuckDB 2.0 erlaubt mehrere Lesevorgänge im Hintergrund, während die Threads der Abfrageverarbeitung mit bereits angekommenen Daten arbeiten.
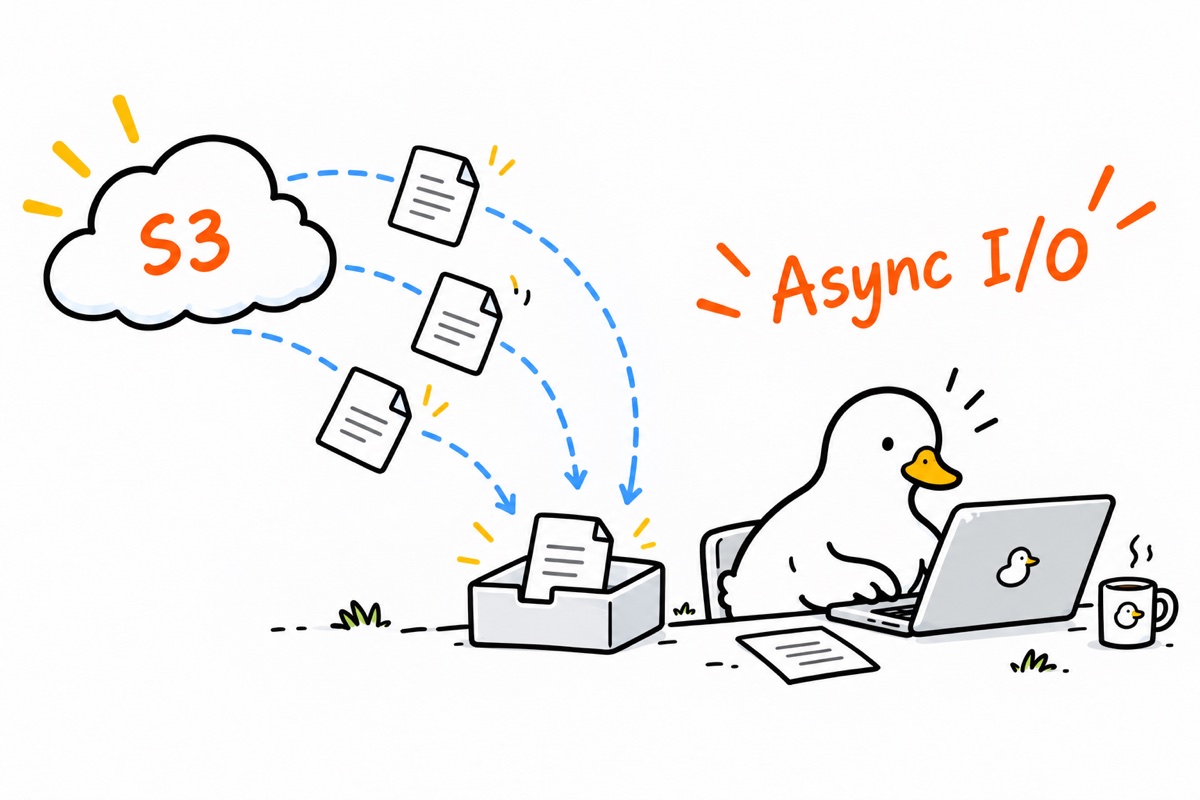
Zum Zeitpunkt des Schreibens nennt die I/O-Dokumentation Unterstützung für Parquet sowie für unkomprimierte, seekbare UTF-8-CSV-Dateien; JSON und DuckDB-eigene Dateien sind weiterhin als synchrones I/O aufgeführt. Der Vorschau-Artikel zu 2.0 erwähnt außerdem Fortschritte bei der Unterstützung des nativen Formats, prüfen Sie also, was Ihre Version kann. I/O-Dokumentation
4. DuckDB als Server: jenseits eines einzelnen Prozesses
DuckDB begann als In-Process-Datenbank, direkt eingebettet in Python-, Rust- und C++-Anwendungen. Dieses Modell macht es unbequem, eine Datenbank zwischen Anwendungen zu teilen oder Abfragen entfernt auszuführen. Version 2.0 führt das Quack-Protokoll und die Anweisung CONNECT ein: DuckDB kann als Server laufen, und Clients schicken SQL zur entfernten Ausführung. Außerdem lassen sich Abfragen an entfernte Datenbanken wie PostgreSQL und MySQL pushdownen, statt die Daten in den lokalen Prozess zu holen.
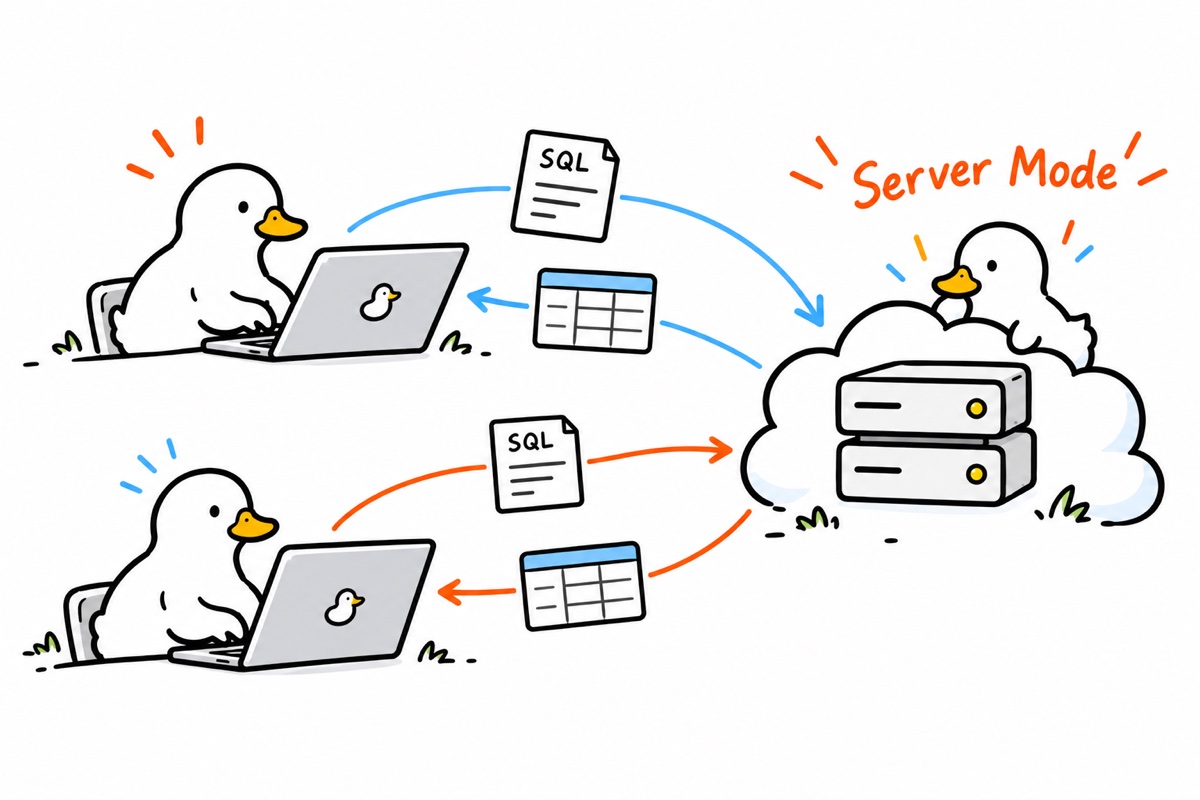
Für den Unternehmenseinsatz ist das wichtig: Teams brauchen einen gemeinsamen Arbeitsbereich. Die Architektur, die ich will, bringt KI näher an die Daten, mit Berechnung dort, wo die Daten hingehören.
Quack allein ist keine vollständige Unternehmenslösung für Berechtigungen, Auditing und Mandantenfähigkeit. Das braucht weiterhin Design auf Anwendungsebene. Was Quack liefert, ist ein Fundament für diese Architektur.
Local-first heißt, Nutzern die Kontrolle über ihre Daten und ihre Berechnung zu geben. Es verlangt nicht, dass alles lokal passiert.
5. Weitere Verbesserungen, die sich lohnen
- Eine neu geschriebene Engine für rekursive CTEs. In einem Graph-Erreichbarkeitstest mit einer Million Kanten sank die Abfragezeit von 4.90 Sekunden auf 0.12 Sekunden, rund 40× schneller. Manche Graph-Traversierungen werden in SQL praktikabler, doch DuckDB ersetzt damit keine spezialisierte Graphdatenbank.
- Native Ersetzungen für ICU-Funktionen. DuckDB gibt die Abhängigkeit von der ICU-Bibliothek auf. In Microbenchmarks war die Zeitzonen-Umrechnung etwa 2.2× schneller und das Filtern mit einer deutschen Collation etwa 2.6× schneller. Ein kleinerer Footprint hilft auch eingebetteten Anwendungen.
- Eine stabile Erweiterungs-API. Eine neu gestaltete C-API, eine versionierte ABI und Unterstützung für selbst gehostete Erweiterungs-Repositories könnten den Wartungsaufwand bei DuckDB-Upgrades deutlich senken. Besonders interessant ist das für Entwickler von Rust-Erweiterungen.
- Trigger und ein PEG-Parser. Trigger können Auditing und die Verarbeitung von Datenänderungen unterstützen. Ein erweiterbarer Parser gibt Erweiterungen tieferen Zugriff auf das SQL-Parsing und könnte domänenspezifische Syntax für Security-Analytics und Observability ermöglichen.
6. Vor dem Upgrade
Version 2.0 ist nicht vollständig abwärtskompatibel.
- Speicherformat. Dateien, die im neuen Standardformat erstellt oder geschrieben werden, kann eine ältere Version nicht öffnen. Wenn ältere Leser weiter unterstützt werden müssen, setzen Sie eine ausdrückliche Speicher-Kompatibilitätsversion. Bestehende Datenbanken lassen sich nach der offiziellen Migrationsanleitung exportieren und importieren.
- Lambda-Syntax. Die alte Syntax ist standardmäßig deaktiviert. Eine vorübergehende Kompatibilitätseinstellung kann sie aktivieren, die Entfernung ist aber für 2.1 geplant.
-- Old
SELECT list_transform([1, 2, 3], x -> x + 1);
-- New
SELECT list_transform([1, 2, 3], lambda x : x + 1);
- C++-Erweiterungen. Prüfen Sie vor dem Upgrade, ob kompatible Builds verfügbar sind.
Prüfen Sie bestehende Abfragen, Datenbankdateien und Erweiterungen von Drittanbietern, bevor Sie Produktionsarbeitslasten umstellen. Desktop-Anwendungen sollten besonders darauf achten, das Dateiformat von Nutzern nicht stillschweigend zu migrieren: Eine ältere App-Version kann die Datei dann möglicherweise nicht mehr öffnen. Migrationsanleitung
7. Fazit
Wer eine CSV-Datei oder ein paar Gigabyte Logs analysieren will, beginnt oft damit, eine Datenbank bereitzustellen, Pipelines zu konfigurieren und Dienste zu betreiben. Für eine große Unternehmensdatenplattform kann das sinnvoll sein, für einzelne Entwickler, Security-Analysten oder eine einmalige Untersuchung ist es nicht immer nötig.
DuckDB bettet eine Analyse-Engine direkt in eine Anwendung ein. Version 2.0 ergänzt den Server-Modus, den Agent Mode und ein reiferes Erweiterungs-Ökosystem. Datenbank, KI-Agent und visuelle Oberfläche können zu einem leichten, einbettbaren Arbeitsbereich für die Datenanalyse zusammenwachsen.
Deshalb baue ich DuckLocal, eine Open-Source-Desktop-App nach dem Local-first-Prinzip für SQL, visuelle Dashboards und gemeinsame Analyse mit KI. Die KI hilft beim Erkunden der Daten, während der Nutzer die Kontrolle behält, die Ausführung nachvollziehbar und das SQL transparent bleibt.
Referenzen
Stand 19. Oktober 2026 ist DuckDB 2.0 noch nicht veröffentlicht. Release-Datum und Funktionsdetails ergeben sich aus der endgültigen offiziellen Ankündigung.